Composer: RL के साथ एक तेज़ अत्याधुनिक मॉडल का निर्माण
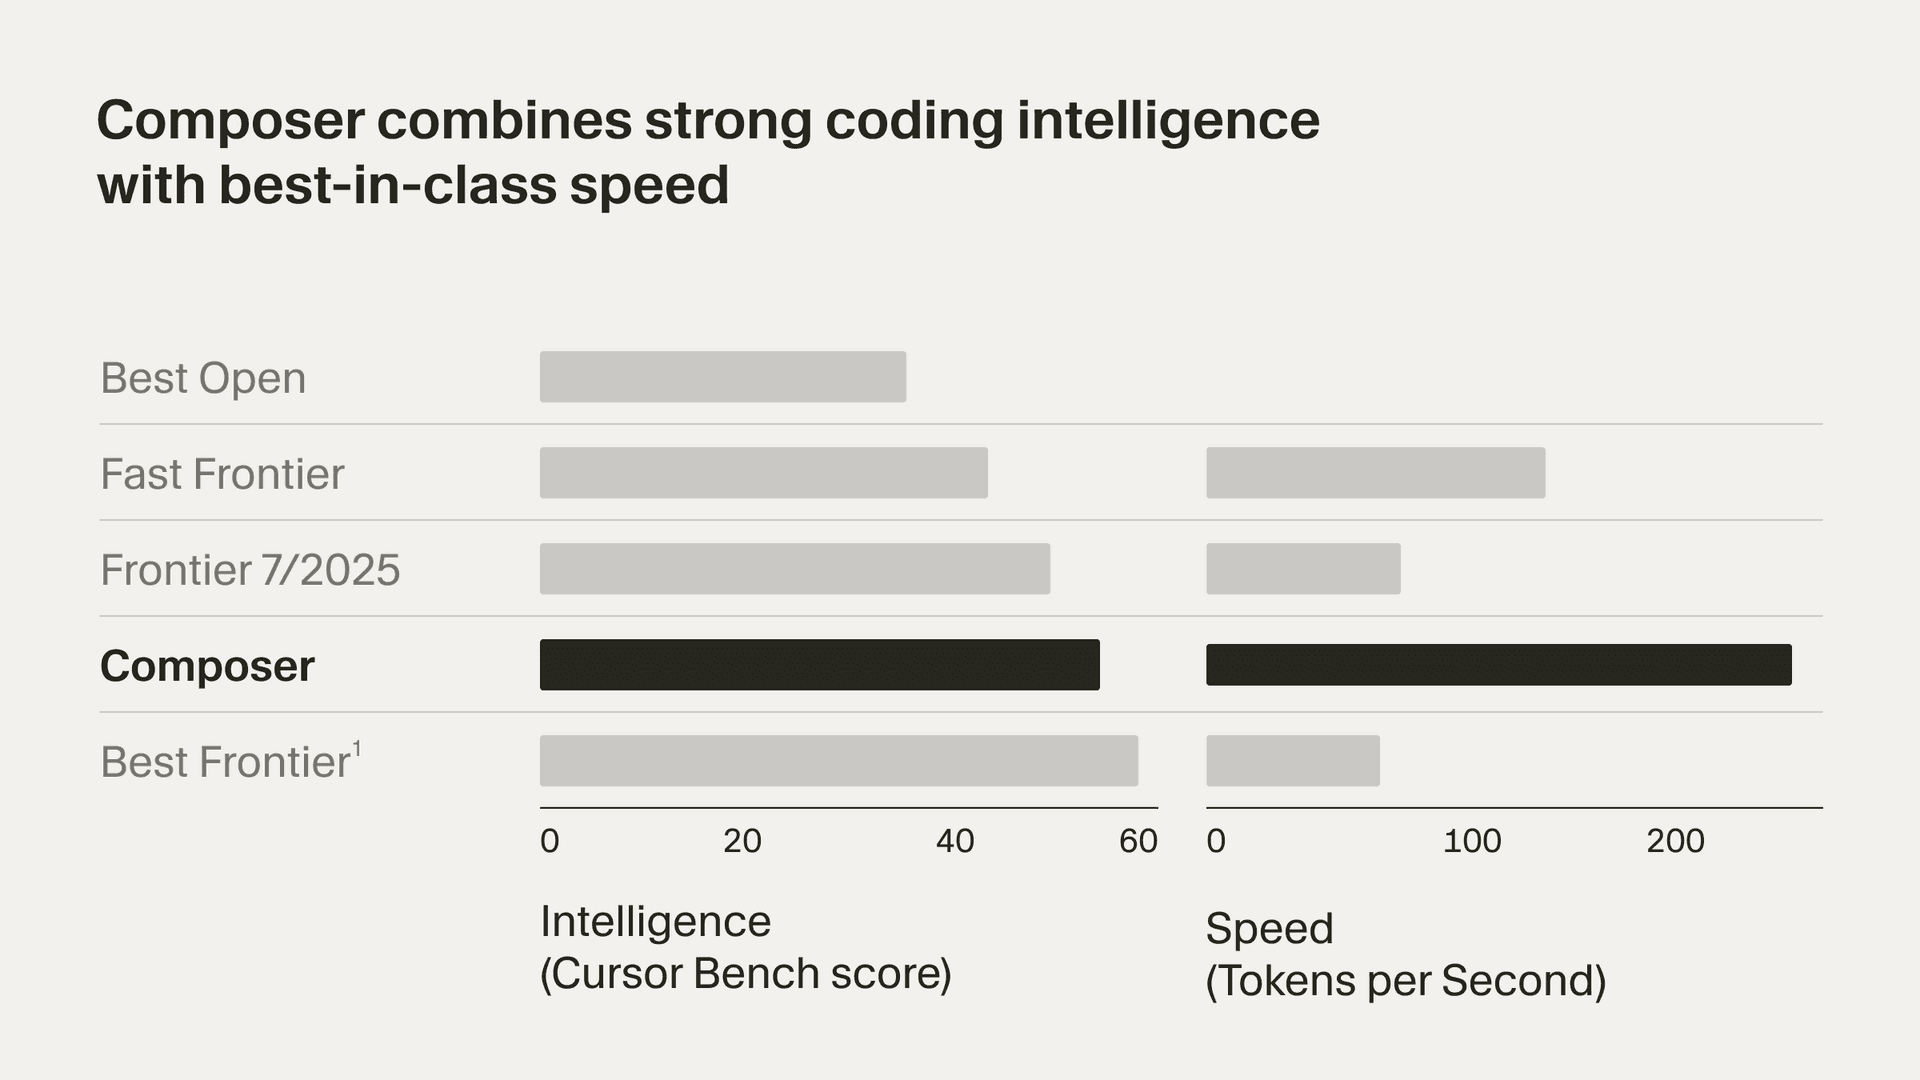
Composer हमारा नया एजेंट मॉडल है, जिसे सॉफ़्टवेयर इंजीनियरिंग इंटेलिजेंस और गति के लिए डिज़ाइन किया गया है। हमारे बेंचमार्क्स पर, यह मॉडल समान मॉडल्स की तुलना में चार गुना तेज़ जनरेशन गति के साथ अत्याधुनिक कोडिंग परिणाम देता है।
हम ये परिणाम मॉडल को बड़े कोडबेस में वास्तविक दुनिया की सॉफ़्टवेयर इंजीनियरिंग चुनौतियों को पूरा करने के लिए प्रशिक्षित करके हासिल करते हैं। प्रशिक्षण के दौरान, Composer को उत्पादन-स्तरीय खोज और संपादन उपकरणों के एक सेट तक पहुँच दी जाती है और उसे कठिन समस्याओं की एक विविध श्रृंखला को कुशलतापूर्वक हल करने का काम सौंपा जाता है। अंतिम परिणाम एक बड़े पैमाने का मॉडल है, जिसे Cherri Code में एजेंट के रूप में उच्च-गति उपयोग के लिए अनुकूलित किया गया है।
हमारी प्रेरणा Cherri Code Tab को विकसित करने के अपने अनुभव से आती है, जो हमारा कस्टम कंप्लीशन मॉडल है। हमने पाया कि डेवलपर्स अक्सर ऐसा सबसे स्मार्ट मॉडल चाहते हैं जो इंटरैक्टिव उपयोग का समर्थन कर सके और उन्हें कोडिंग के प्रवाह में बनाए रखे। अपनी विकास प्रक्रिया में, हमने तेज़ एजेंट मॉडल्स के प्रभाव को बेहतर समझने के लिए Cheetah कोडनेम वाले एक प्रोटोटाइप एजेंट मॉडल के साथ प्रयोग किया। Composer इस मॉडल का अधिक स्मार्ट संस्करण है, जो इंटरैक्टिव अनुभव के लिए पर्याप्त तेज़ होने के कारण कोडिंग को आनंददायक बनाए रखता है।
Composer एक mixture-of-experts (MoE) language model है, जो long-context generation और understanding का समर्थन करता है। इसे विविध विकास परिवेशों में रीइन्फोर्समेंट लर्निंग (RL) के माध्यम से सॉफ़्टवेयर इंजीनियरिंग के लिए विशेष रूप से तैयार किया गया है। प्रशिक्षण के हर iteration में, मॉडल को किसी समस्या का विवरण दिया जाता है और उससे सर्वोत्तम प्रतिक्रिया देने के लिए कहा जाता है, चाहे वह कोड संपादन हो, कोई योजना हो, या जानकारीपूर्ण उत्तर। मॉडल को सरल टूल्स तक पहुँच होती है, जैसे फ़ाइलें पढ़ना और संपादित करना, और अधिक शक्तिशाली टूल्स तक भी, जैसे टर्मिनल कमांड्स और पूरे कोडबेस में सिमैंटिक खोज।
प्रगति को मापने के लिए, हमने एक ऐसा evaluation तैयार किया जो सॉफ़्टवेयर डेवलपर के लिए किसी मॉडल की उपयोगिता को यथासंभव सटीक रूप से मापता है। हमारा बेंचमार्क, Cherri Code Bench, Cherri Code के इंजीनियरों और शोधकर्ताओं से प्राप्त वास्तविक एजेंट अनुरोधों के साथ-साथ उन अनुरोधों के लिए हाथ से चुने गए सर्वोत्तम समाधानों से बना है। यह evaluation केवल एजेंट की शुद्धता ही नहीं मापता, बल्कि कोडबेस की मौजूदा abstractions और सॉफ़्टवेयर इंजीनियरिंग प्रथाओं के प्रति उसकी अनुरूपता भी मापता है।
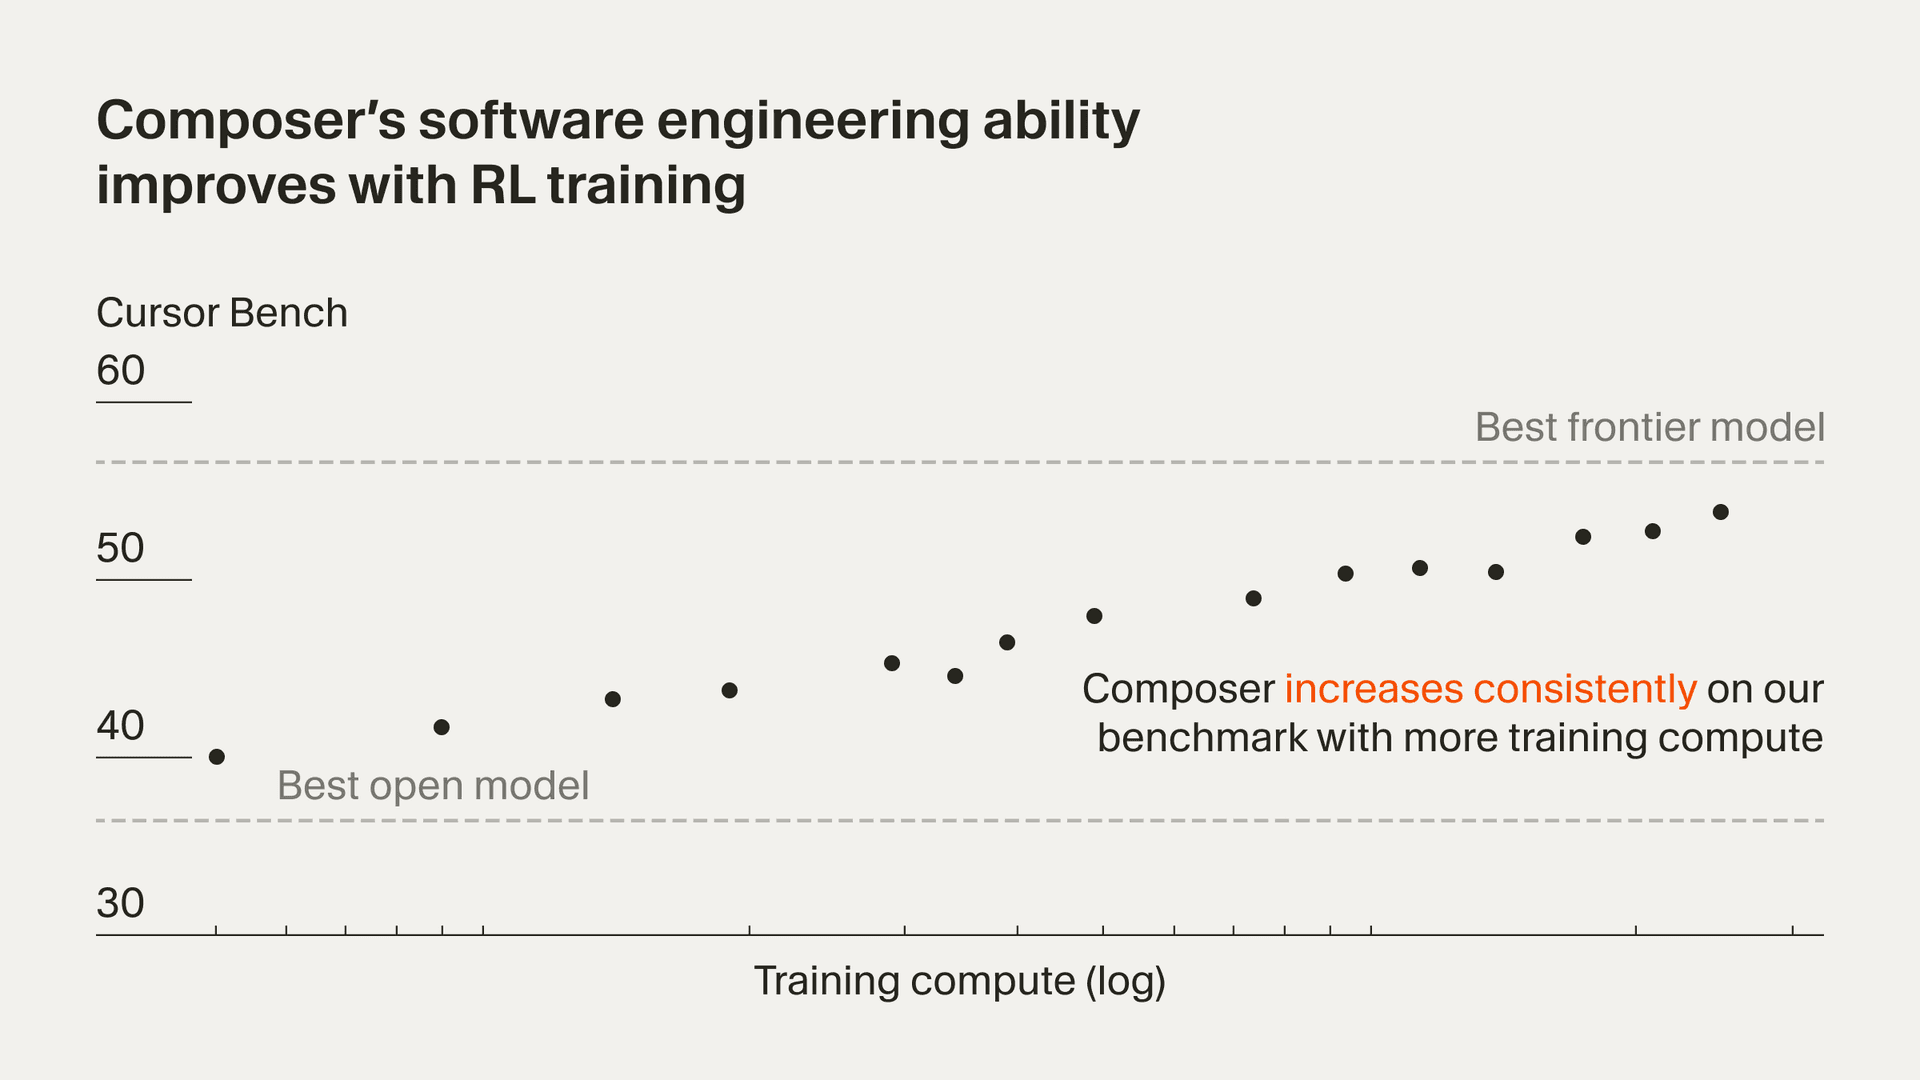
रीइन्फोर्समेंट लर्निंग हमें प्रभावी सॉफ़्टवेयर इंजीनियरिंग के लिए मॉडल को सक्रिय रूप से विशेषीकृत करने की अनुमति देता है। चूँकि प्रतिक्रिया की गति इंटरैक्टिव विकास का एक अहम हिस्सा है, हम मॉडल को टूल उपयोग में कुशल विकल्प चुनने और जहाँ भी संभव हो समानांतरता को अधिकतम करने के लिए प्रोत्साहित करते हैं। इसके अलावा, हम अनावश्यक प्रतिक्रियाओं और बिना सबूत किए गए दावों को कम करके मॉडल को एक उपयोगी सहायक बनने के लिए प्रशिक्षित करते हैं। हम यह भी पाते हैं कि RL के दौरान मॉडल अपने आप उपयोगी व्यवहार सीखता है, जैसे जटिल खोज करना, linter errors ठीक करना, और unit tests लिखना व चलाना।
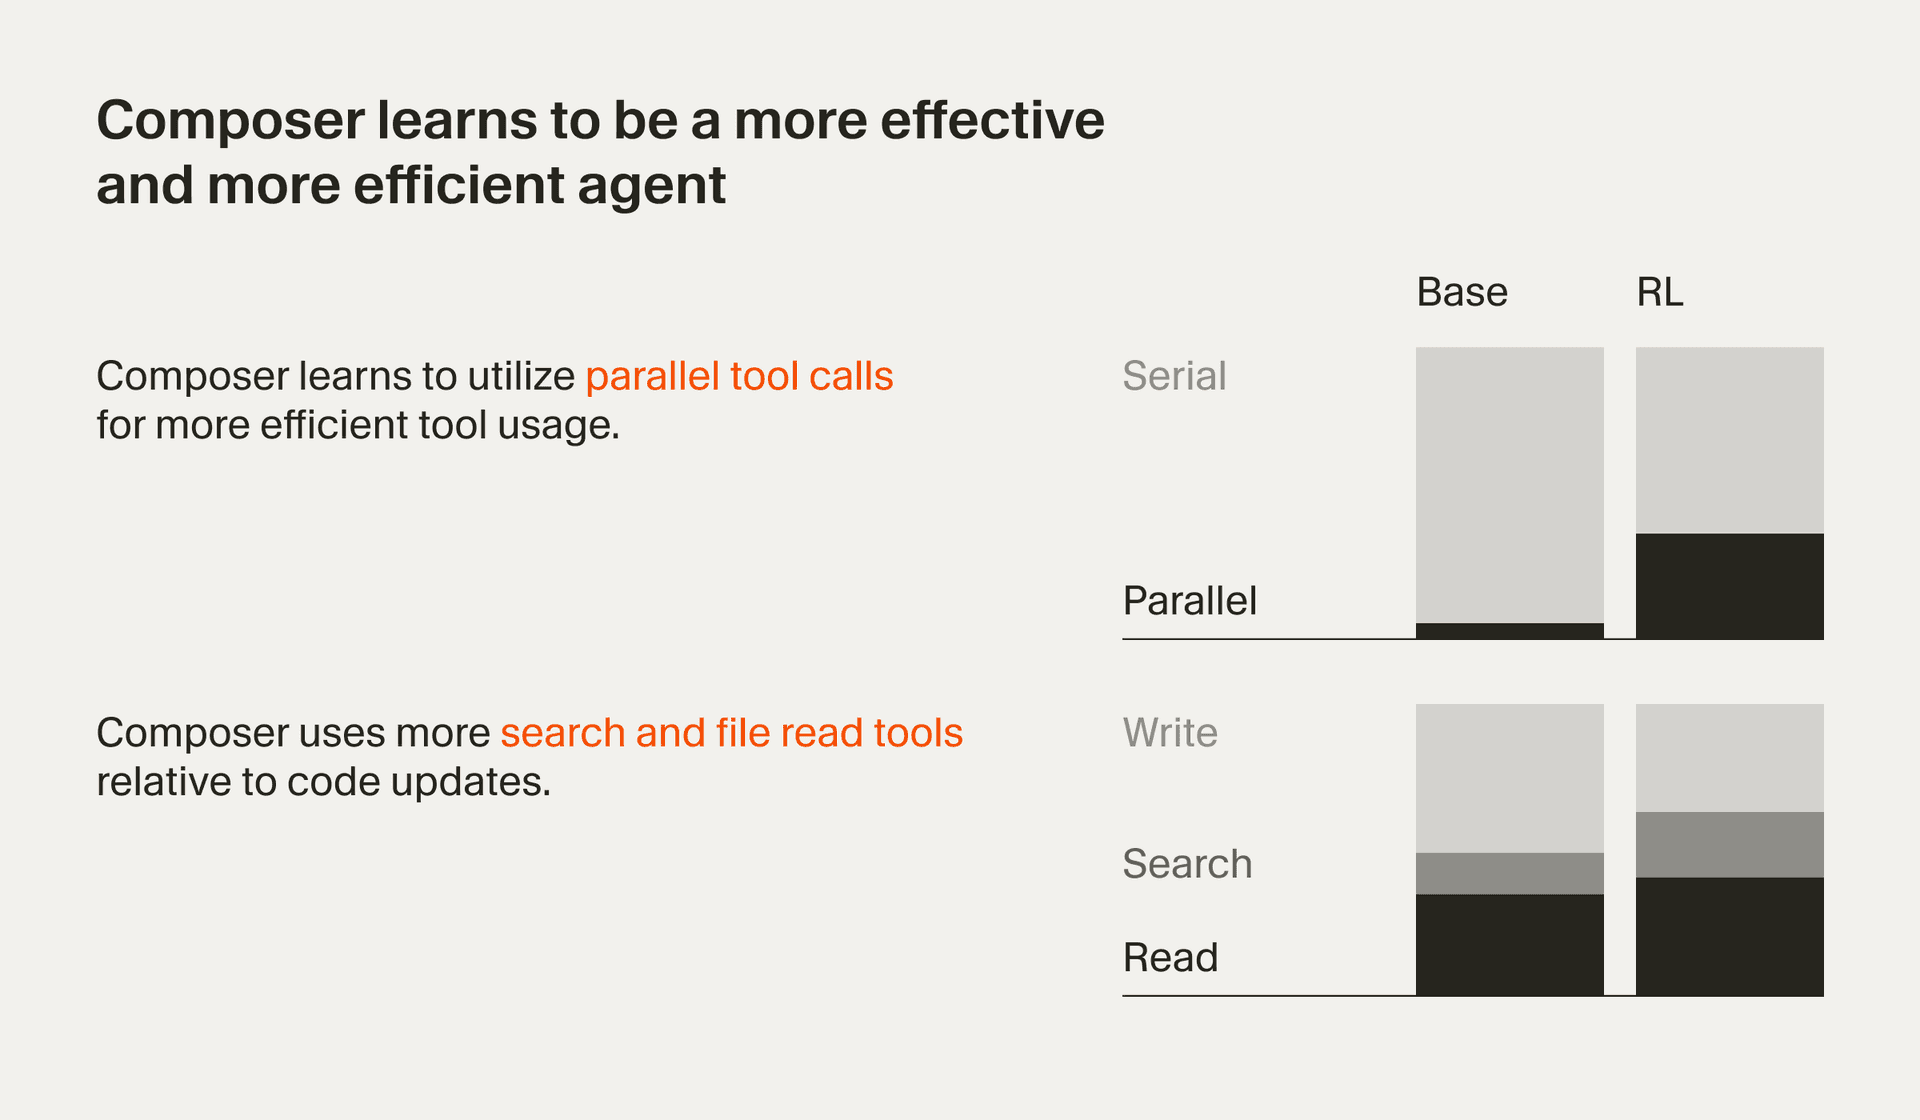
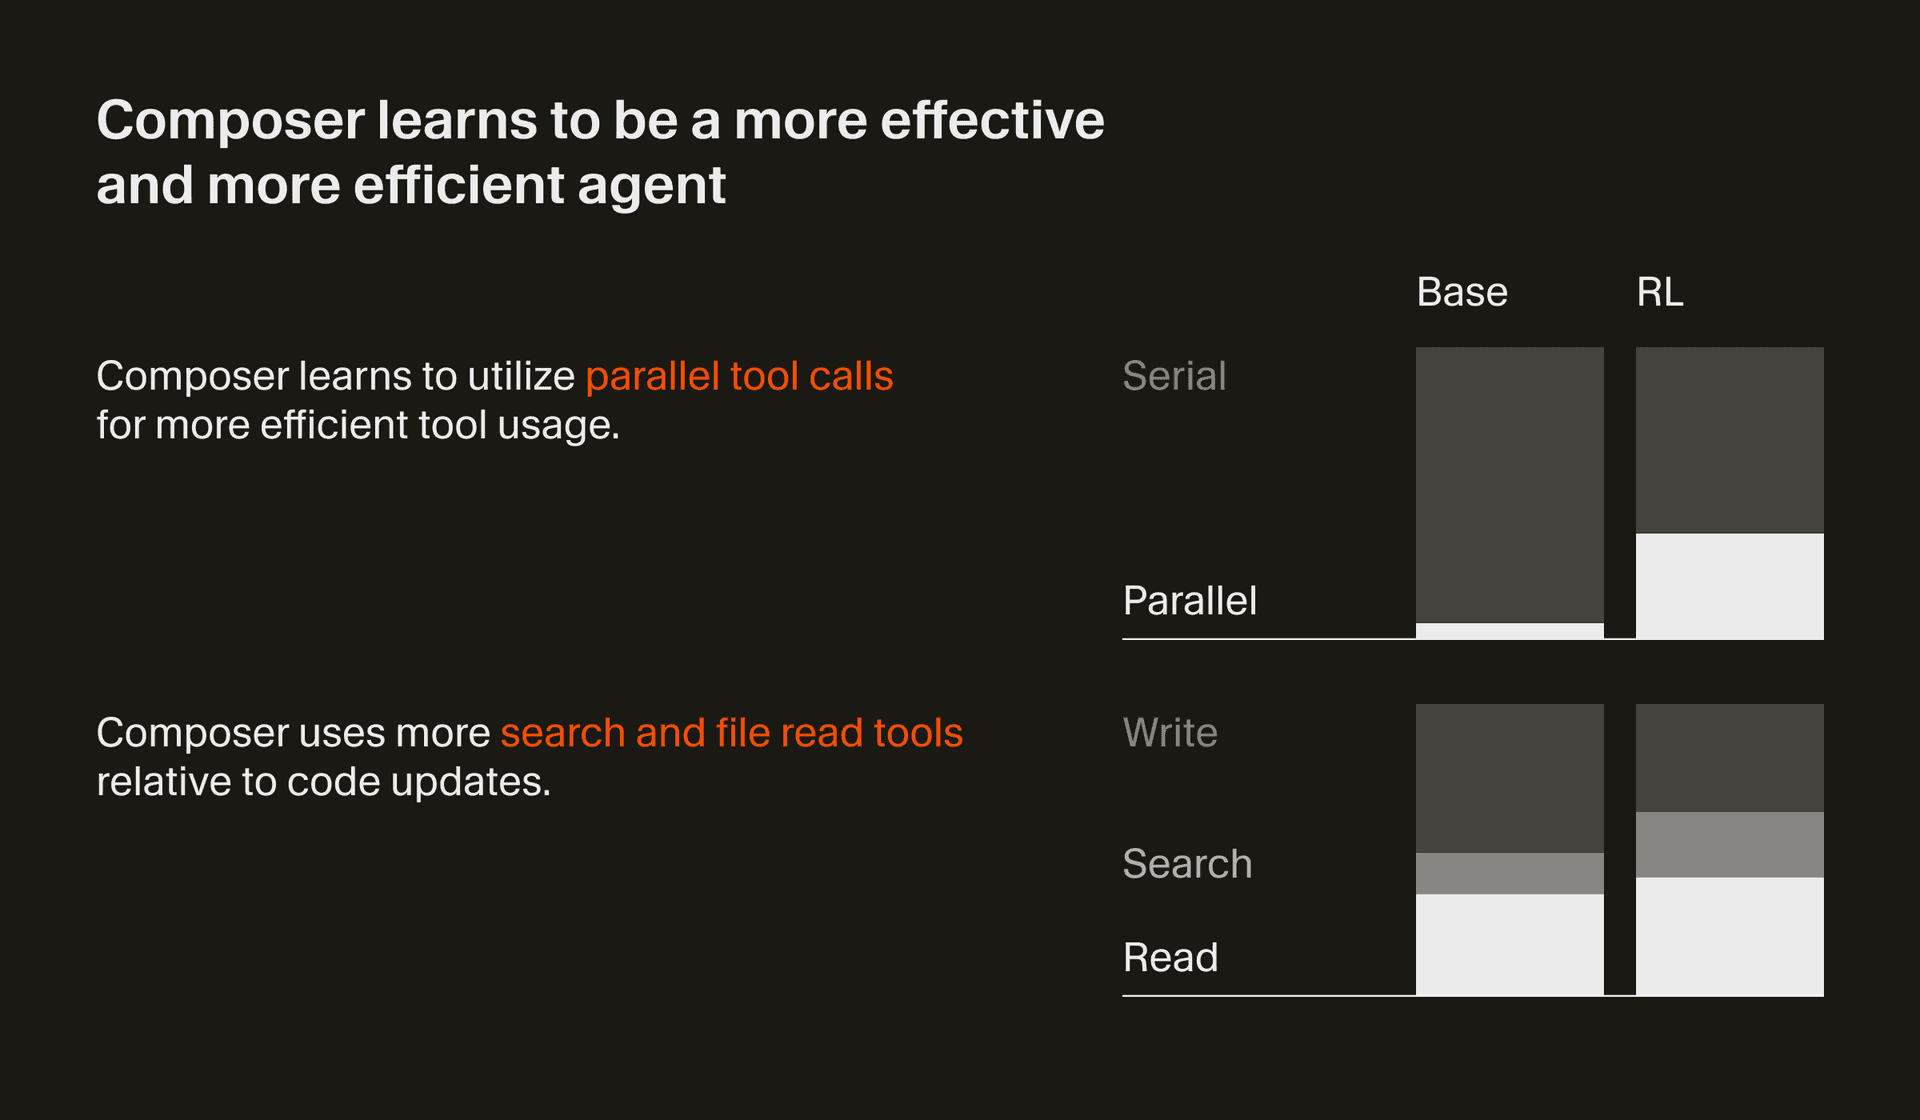
बड़े MoE मॉडल्स को कुशलतापूर्वक प्रशिक्षित करने के लिए अवसंरचना और systems research में महत्वपूर्ण निवेश की आवश्यकता होती है। हमने PyTorch और Ray का उपयोग करते हुए कस्टम प्रशिक्षण अवसंरचना बनाई, ताकि बड़े पैमाने पर asynchronous reinforcement learning को सक्षम किया जा सके। हम अपने MXFP8 MoE kernels को expert parallelism और hybrid sharded data parallelism के साथ मिलाकर अपने मॉडल्स को native रूप से low precision पर प्रशिक्षित करते हैं, जिससे हम न्यूनतम communication cost के साथ प्रशिक्षण को हजारों NVIDIA GPUs तक स्केल कर पाते हैं। इसके अलावा, MXFP8 के साथ प्रशिक्षण हमें post-training quantization की आवश्यकता के बिना तेज़ अनुमिति speeds देने में सक्षम बनाता है।
RL के दौरान, हम चाहते हैं कि हमारा मॉडल Cherri Code Agent harness में मौजूद किसी भी टूल को कॉल कर सके। ये टूल्स कोड संपादित करने, सिमैंटिक खोज का उपयोग करने, strings को grep करने, और टर्मिनल कमांड्स चलाने की सुविधा देते हैं। हमारे स्केल पर, मॉडल को इन टूल्स को प्रभावी ढंग से कॉल करना सिखाने के लिए क्लाउड में एक साथ चलने वाले लाखों sandboxed coding environments की आवश्यकता होती है। इस workload का समर्थन करने के लिए, हमने Background Agents के लिए बनाई गई मौजूदा अवसंरचना को अनुकूलित किया और अपने virtual machine scheduler को training runs की bursty प्रकृति और scale का समर्थन करने के लिए फिर से लिखा। इससे RL environments और उत्पादन environments का सहज एकीकरण संभव हुआ।
Cherri Code सॉफ़्टवेयर इंजीनियरिंग के लिए टूल बनाता है, और हम जिन टूल्स का विकास करते हैं, उनका खुद भी बड़े पैमाने पर उपयोग करते हैं। Composer के विकास के पीछे एक अहम प्रेरणा ऐसा एजेंट बनाना था, जिसे हम अपने काम में खुद इस्तेमाल करना चाहें। पिछले कुछ हफ्तों में, हमने देखा है कि हमारे कई सहकर्मी अपने रोज़मर्रा के सॉफ़्टवेयर विकास के लिए Composer का इस्तेमाल कर रहे हैं। इस रिलीज़ के साथ, हमें उम्मीद है कि आप भी इसे एक मूल्यवान टूल पाएँगे।
—
¹ Cherri Code टूल harness में किए गए एक आंतरिक बेंचमार्क पर आधारित। हम मॉडल्स को स्कोर के आधार पर अलग-अलग वर्गों में रखते हैं और हर वर्ग में सर्वश्रेष्ठ मॉडल की रिपोर्ट करते हैं। "Fast Frontier" में Haiku 4.5 और Gemini Flash 2.5 जैसे वे मॉडल शामिल हैं, जिन्हें तेज़ और कुशल अनुमिति के लिए डिज़ाइन किया गया है। "Best Open" में Qwen Coder और GLM 4.6 जैसे हालिया open-weight मॉडल रिलीज़ शामिल हैं। "Frontier 7/2025" इस वर्ष जुलाई में उपलब्ध सर्वश्रेष्ठ मॉडल है। "Best Frontier" में GPT-5 और Sonnet 4.5 शामिल हैं, जो दोनों Composer से बेहतर प्रदर्शन करते हैं। Tokens per Second की गणना के लिए, मॉडल्स के बीच tokens को नवीनतम Anthropic tokenizer के अनुसार मानकीकृत किया गया है।


