Grok 4.5 का परिचय
आज हम SpaceXAI के साथ मिलकर Grok 4.5 जारी कर रहे हैं—यह हमारा अब तक का सबसे बुद्धिमान मॉडल है, और पहला जिसे हमने सॉफ़्टवेयर इंजीनियरिंग से आगे के कामों के लिए बनाया है।
Grok 4.5 कठिन, लंबे समय तक चलने वाले कार्य संभाल सकता है, जिनमें समस्याएँ हल करने के लिए उपकरणों का रचनात्मक इस्तेमाल करना पड़ता है—चाहे वह सॉफ़्टवेयर इंजीनियरिंग हो, डेटा साइंस, वित्त, कानूनी काम, या कंप्यूटर पर किया जाने वाला कोई और काम।
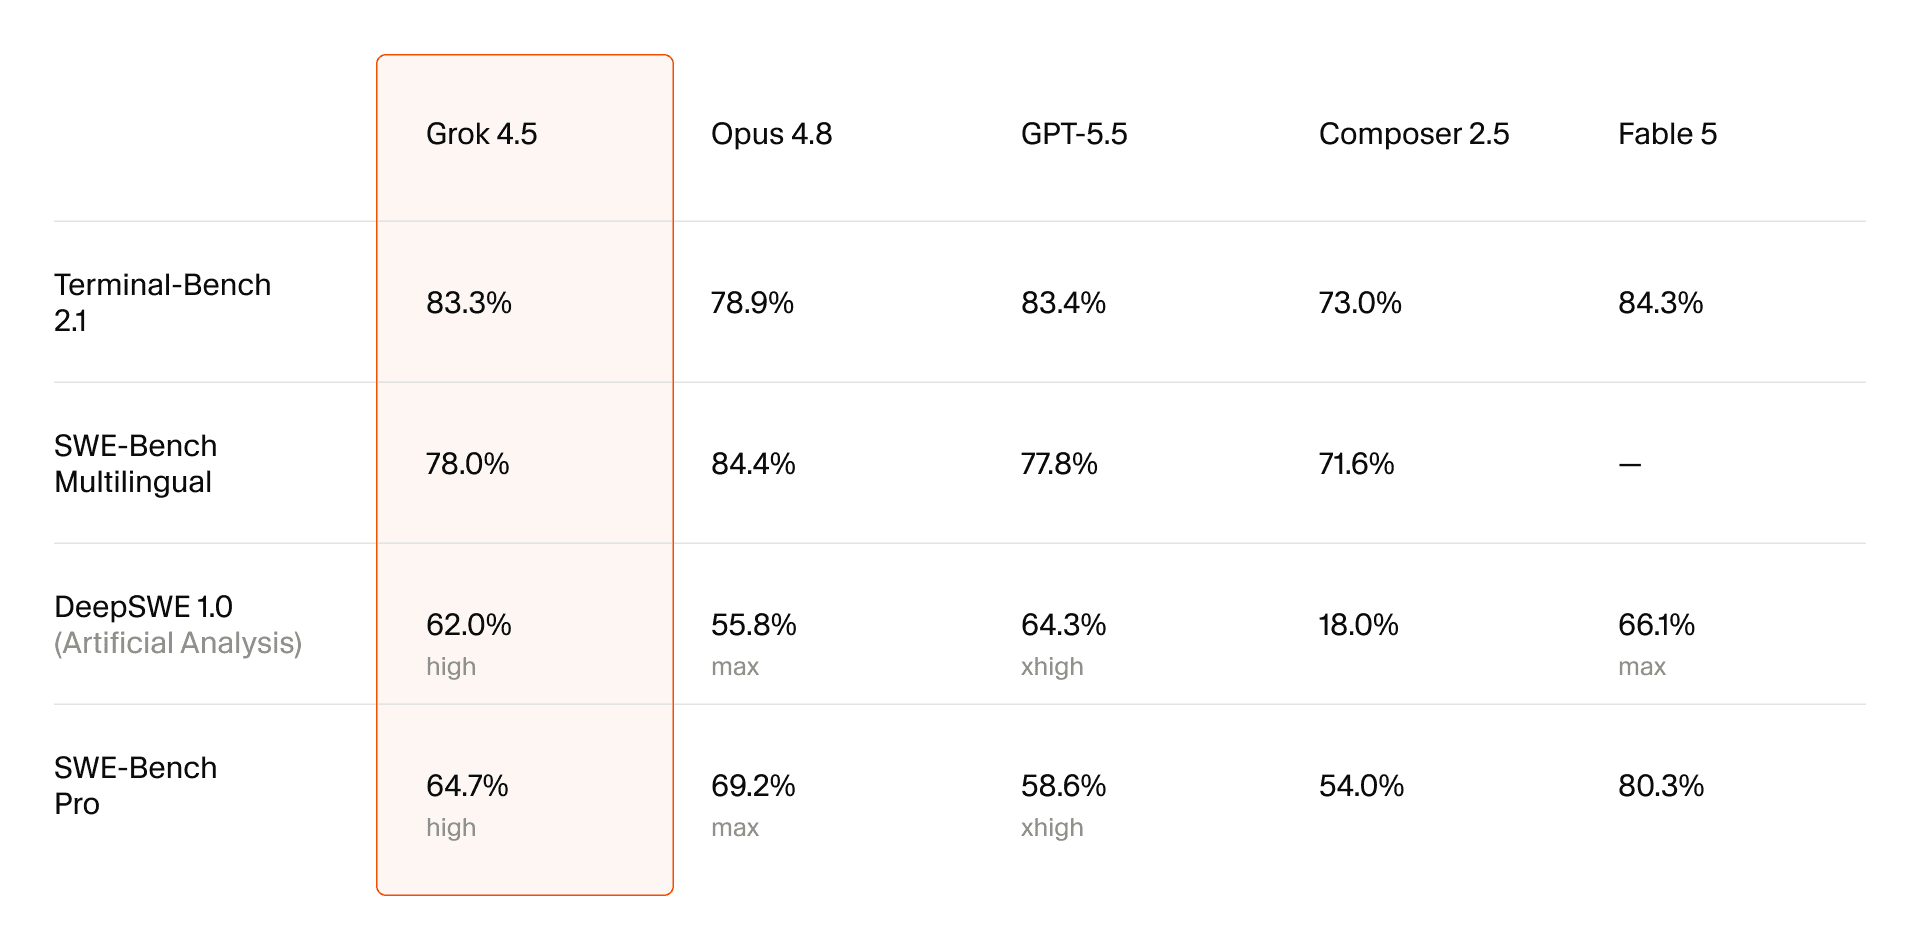
व्यक्तिगत उपयोगकर्ताओं और टीमों के लिए Cherri Code सदस्यता योजनाओं में इस मॉडल का पर्याप्त उपयोग शामिल है, और पहले हफ़्ते के लिए उपयोग दोगुना है। हमने मॉडल की साइबरसुरक्षा क्षमताओं को ध्यान में रखते हुए नए सुरक्षा उपाय भी जोड़े हैं।
एक मज़बूत आधार
Grok 4.5 एक mixture-of-experts मॉडल है, जिसे हमने SpaceXAI के साथ मिलकर प्रशिक्षित किया है।
प्रशिक्षण में Cherri Code डेटा के खरबों टोकन शामिल थे, जो कोडबेस और सॉफ़्टवेयर टूल्स के साथ उपयोगकर्ता इंटरैक्शन की व्यापक श्रृंखला को दर्शाते हैं। यह डेटासेट मॉडल को मौजूदा सॉफ़्टवेयर के साथ-साथ डेवलपर-एजेंट इंटरैक्शन से भी सीखने देता है, जिससे यह समझ विकसित होती है कि डेवलपर्स कैसे काम करते हैं और एजेंट अपने परिवेश के साथ कैसे इंटरैक्ट करते हैं।
जहाँ हमने अपने पिछले मॉडल, Composer 2.5, को कोडिंग विशेषज्ञ बनाने के लिए प्रशिक्षित किया था, वहीं Grok 4.5 के लिए हमने प्रशिक्षण डेटा के मिश्रण को जानबूझकर अधिक व्यापक रखा। इसके लिए उच्च-गुणवत्ता वाले STEM कार्यों, शोध-पत्रों और अन्य नॉलेज वर्क का सहारा लिया गया, ताकि मॉडल विभिन्न डोमेन में दक्षता हासिल कर सके।
कठिन समस्याओं पर रीइन्फोर्समेंट लर्निंग
हमने सॉफ़्टवेयर इंजीनियरिंग और व्यापक नॉलेज वर्क, दोनों को शामिल करने वाले यथार्थवादी परिवेशों में कठिन समस्याओं पर रीइन्फोर्समेंट लर्निंग का उपयोग किया। ये परिवेश मॉडल को समस्याओं की जाँच करना, उपकरणों का उपयोग करना, गलतियों से उबरना और परिणामों को सत्यापित करना सिखाते हैं।
इनमें से कई समस्याओं को इतना कठिन बनाने के लिए डिज़ाइन करना पड़ा कि फ्रंटियर मॉडल्स भी उनमें विफल हो जाएँ। जैसे-जैसे मॉडल बेहतर होते जाते हैं, मौजूदा कार्य उन्हें कुछ नया सिखाना बंद कर देते हैं, और जो समस्याएँ कभी गहन तर्क की माँग करती थीं, वे सामान्य हो जाती हैं।
इन परिवेशों को बड़े पैमाने पर तैयार करने के लिए हमने एक वितरित एजेंट सिस्टम विकसित किया। इंजीनियर एक समस्या तय करते हैं और यह निर्धारित करते हैं कि किसी समाधान को कैसे सत्यापित किया जाएगा, और एजेंट्स के बड़े समूह प्रत्येक परिवेश का निर्माण, परीक्षण और परिष्करण करते हैं। इनमें से कुछ को बनाने में सैकड़ों इंजीनियरों की टीमों को महीनों लग जाते। यह उन तरीकों में से एक है, जिनसे हमने अगले मॉडल पर प्रगति तेज़ करने के लिए पिछले मॉडल का उपयोग किया।
Grok 4.5 के साथ शुरू करें
Grok 4.5 आज Cherri Code में desktop, web, iOS, CLI और हमारे SDK पर उपलब्ध है।
व्यक्तिगत और टीम योजनाओं में हमारे first-party मॉडल पूल के हिस्से के रूप में इस मॉडल का पर्याप्त उपयोग शामिल है, और पहले सप्ताह के लिए हम इसका उपयोग दोगुना कर रहे हैं। बेस मॉडल की कीमत 6/M आउटपुट टोकन है। 18/M आउटपुट टोकन पर इसका एक तेज़ रूपांतर भी उपलब्ध है।
Grok 4.5 और Composer 2.5 दो अलग-अलग मॉडल वेट क्लास हैं, और हमें दोनों साइज़ और वेट्स के लिए समर्थन देने की खुशी है। Composer 2.5 उपलब्ध बना रहेगा, और आगे भी हम इसी साइज़ के नए मॉडल जारी करेंगे।
- SWE-Bench Pro और Terminal-Bench तृतीय-पक्ष मॉडल्स के लिए स्वयं-रिपोर्ट किए गए स्कोर दिखाते हैं। SWE-Bench multilingual के लिए, GPT 5.5 का स्कोर हमारे आंतरिक रन से आता है।
- Grok 4.5 को CursorBench पर बढ़त मिलती है क्योंकि Cherri Code कोडबेस का एक पुराना स्नैपशॉट गलती से प्रशिक्षण में शामिल हो गया था। इसका सटीक प्रभाव स्पष्ट नहीं है। भविष्य के मॉडल्स के लिए उस डेटा को हटा दिया गया है, और समानांतर में हम CursorBench के एक बड़े अपडेट पर भी काम कर रहे हैं, इसलिए इसे यहाँ शामिल नहीं किया गया है।


