बड़े कोडबेस का सुरक्षित अनुक्रमण

सिमैंटिक खोज एजेंट के प्रदर्शन को प्रभावित करने वाले सबसे बड़े कारकों में से एक है। हमारे हालिया मूल्यांकन में, इससे औसतन प्रतिक्रिया की सटीकता 12.5% बढ़ी, ऐसे कोड परिवर्तन बने जो कोडबेस में बने रहने की अधिक संभावना रखते थे, और कुल अनुरोध संतुष्टि भी बढ़ी।
सिमैंटिक खोज को सक्षम करने के लिए, जब आप एक प्रोजेक्ट खोलते हैं तो Cherri Code आपके कोडबेस का एक खोजयोग्य इंडेक्स बनाता है। छोटे प्रोजेक्ट्स में यह लगभग तुरंत हो जाता है। लेकिन बड़े रिपॉज़िटरी, जिनमें दसियों हज़ार फ़ाइलें होती हैं, अगर उनका अनुक्रमण सीधे-सीधे किया जाए तो उन्हें संसाधित होने में घंटों लग सकते हैं, और जब तक उस काम का कम-से-कम 80% पूरा नहीं हो जाता, तब तक सिमैंटिक खोज उपलब्ध नहीं होती।
हमने अनुक्रमण तेज़ करने के तरीके खोजे। इसकी शुरुआत एक सरल अवलोकन से हुई: ज़्यादातर टीमें एक ही कोडबेस की लगभग समान प्रतियों पर काम करती हैं। वास्तव में, एक ही कोडबेस के क्लोन एक संगठन के उपयोगकर्ताओं में औसतन 92% समान होते हैं।
इसका मतलब है कि जब कोई नया सदस्य जुड़ता है या मशीन बदलता है, तो हर बार हर इंडेक्स को शुरू से बनाने के बजाय हम टीम के किसी सदस्य के मौजूदा इंडेक्स का सुरक्षित तरीके से दोबारा उपयोग कर सकते हैं। इससे सबसे बड़े रिपॉज़िटरी में समय घंटों से घटकर सेकंडों में आ जाता है।
पहला इंडेक्स बनाना
Cherri Code Merkle tree का इस्तेमाल करके किसी कोडबेस का पहला दृश्य बनाता है, जिससे वह सब कुछ फिर से प्रोसेस किए बिना ठीक-ठीक पता लगा सकता है कि कौन-सी फ़ाइलें और डायरेक्टरियाँ बदली हैं। Merkle tree में हर फ़ाइल का एक क्रिप्टोग्राफ़िक हैश होता है, साथ ही हर फ़ोल्डर के हैश भी होते हैं, जो उसके चाइल्ड आइटम्स के हैश पर आधारित होते हैं।
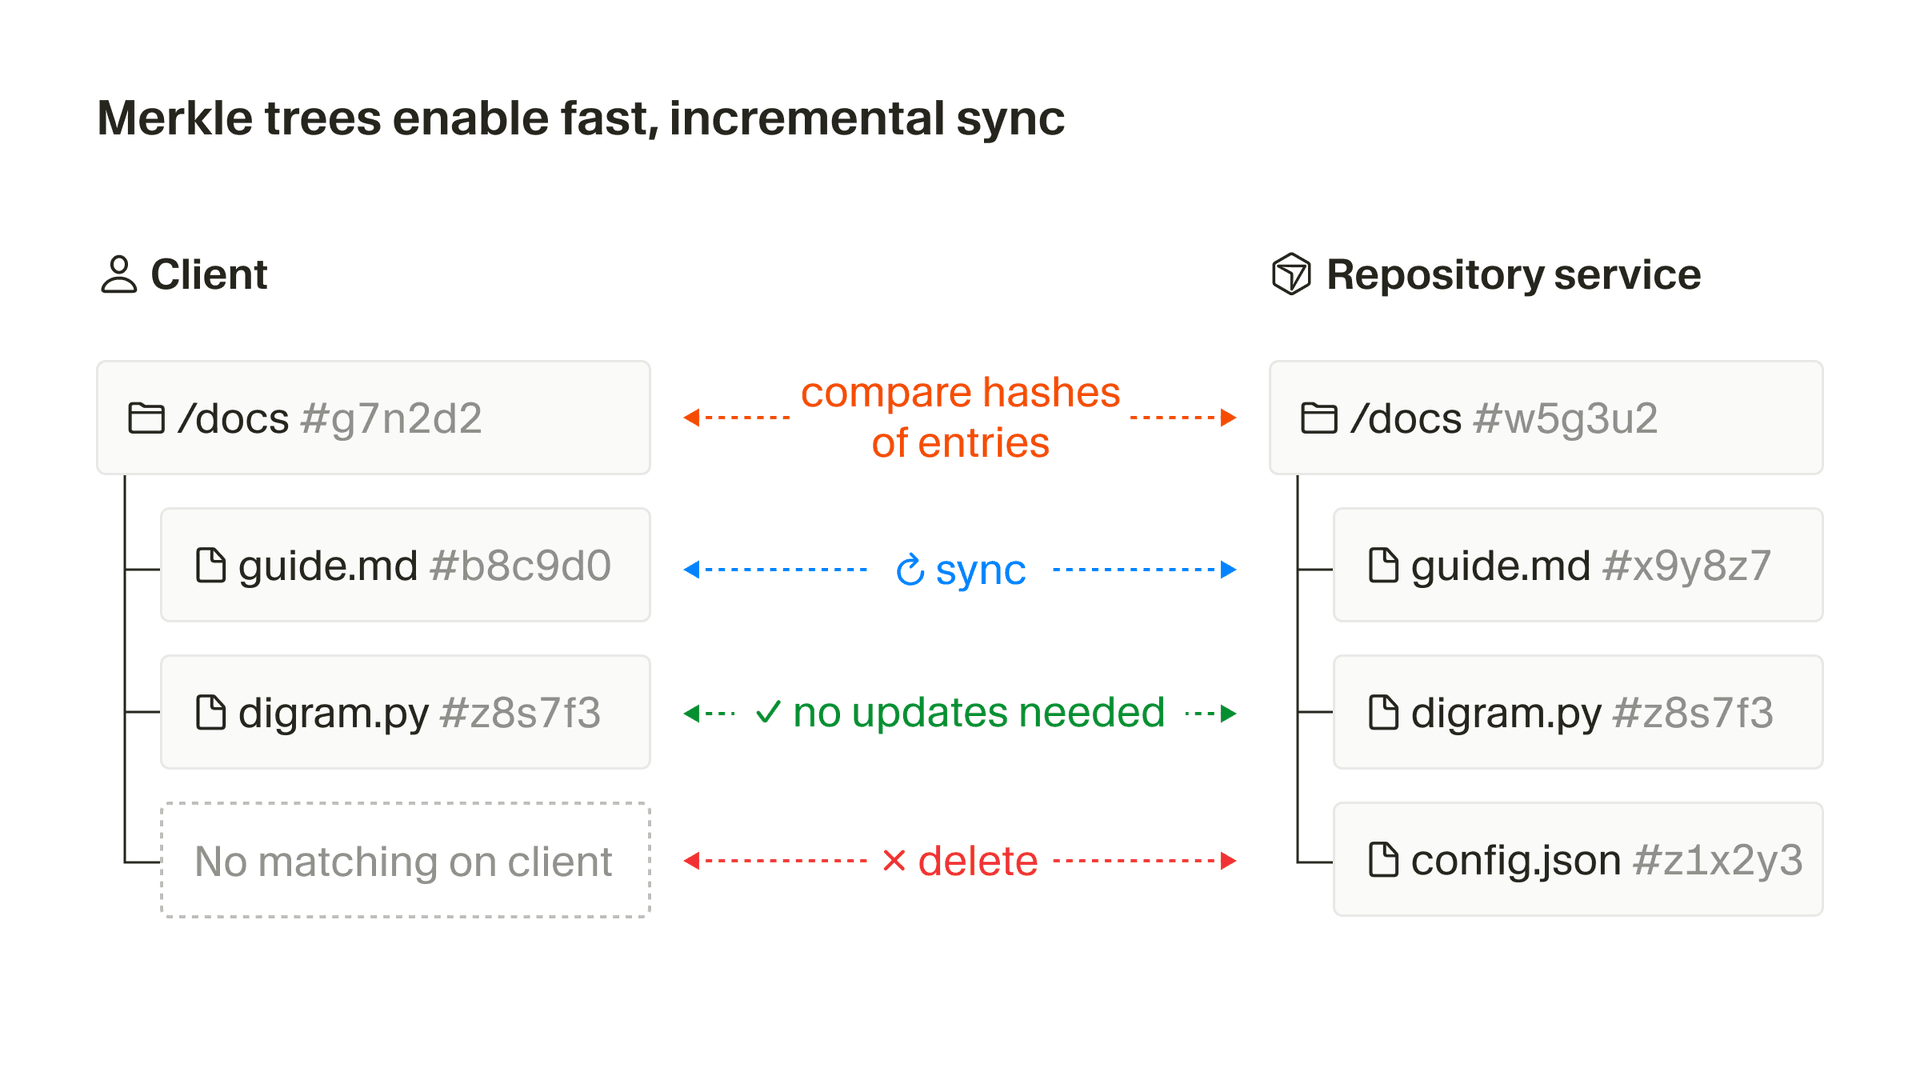
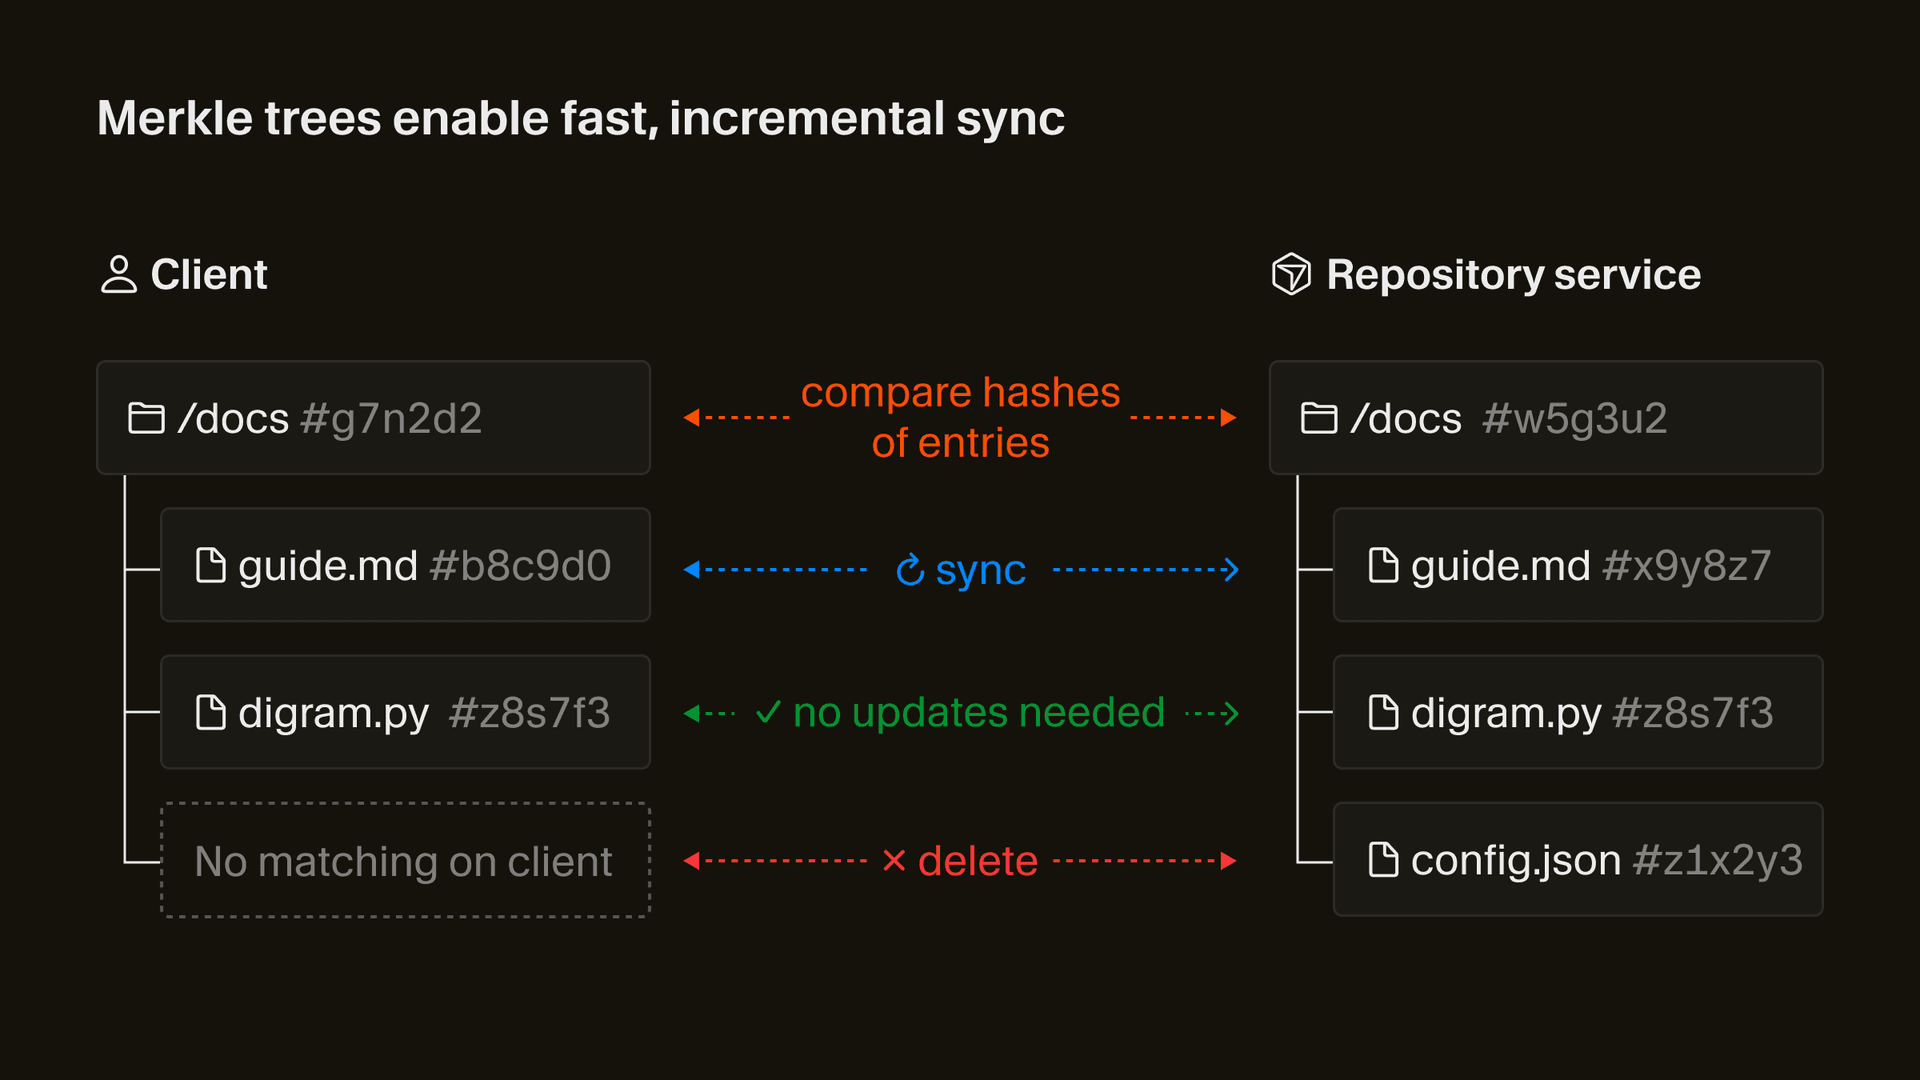
क्लाइंट-साइड पर किए गए छोटे संपादन केवल संपादित फ़ाइल के हैश और कोडबेस के रूट तक की मूल डायरेक्टरियों के हैश बदलते हैं। Cherri Code उन हैश की तुलना सर्वर के संस्करण से करता है, ताकि ठीक-ठीक देखा जा सके कि दोनों Merkle tree कहाँ अलग होते हैं। जिन एंट्रीज़ के हैश अलग होते हैं, उन्हें सिंक किया जाता है। जो एंट्रीज़ मेल खाती हैं, उन्हें छोड़ दिया जाता है। क्लाइंट पर जो एंट्री मौजूद नहीं होती, उसे सर्वर से हटा दिया जाता है, और सर्वर पर जो एंट्री मौजूद नहीं होती, उसे जोड़ा जाता है। सिंक प्रक्रिया कभी भी क्लाइंट-साइड की फ़ाइलों में बदलाव नहीं करती।
Merkle tree का यह तरीका हर सिंक पर ट्रांसफ़र किए जाने वाले डेटा की मात्रा को काफ़ी घटा देता है। पचास हज़ार फ़ाइलों वाले किसी कार्यस्थान में, सिर्फ़ फ़ाइलनाम और SHA-256 हैश मिलाकर ही लगभग 3.2 MB डेटा हो जाता है। इस tree के बिना, आपको हर अपडेट पर यह डेटा ट्रांसफ़र करना पड़ता। tree के साथ, Cherri Code केवल उन्हीं ब्रांच पर चलता है जहाँ हैश अलग होते हैं।
जब कोई फ़ाइल बदलती है, तो Cherri Code उसे सिंटैक्टिक चंक्स में बाँट देता है। इन चंक्स को उन एम्बेडिंग्स में रूपांतरित किया जाता है जो सिमैंटिक खोज को सक्षम करती हैं। एम्बेडिंग्स बनाना महँगा चरण है, इसलिए Cherri Code इसे पृष्ठभूमि में असिंक्रोनस तरीके से करता है।
ज़्यादातर संपादन में ज़्यादातर चंक्स अपरिवर्तित रहते हैं। Cherri Code chunk content के आधार पर एम्बेडिंग्स को कैश करता है। अपरिवर्तित चंक्स कैश से मिल जाते हैं, और inference समय पर वह लागत फिर से चुकाए बिना एजेंट की प्रतिक्रियाएँ तेज़ बनी रहती हैं। नतीजतन, बना हुआ इंडेक्स अपडेट करने में तेज़ और बनाए रखने में हल्का होता है।
पुनः उपयोग के लिए सर्वश्रेष्ठ इंडेक्स खोजना
ऊपर दी गई अनुक्रमण पाइपलाइन, जब कोई कोडबेस Cherri Code में नया होता है, तो हर फ़ाइल अपलोड करती है। हालांकि, किसी संगठन के नए उपयोगकर्ताओं को उस पूरी प्रक्रिया से गुज़रने की आवश्यकता नहीं होती।
जब कोई नया उपयोगकर्ता जुड़ता है, तो क्लाइंट नए कोडबेस के लिए Merkle tree की गणना करता है और उस tree से similarity hash (simhash) नाम का एक मान निकालता है। यह एक एकल मान होता है, जो कोडबेस में मौजूद फ़ाइल सामग्री हैश का सारांश होता है।
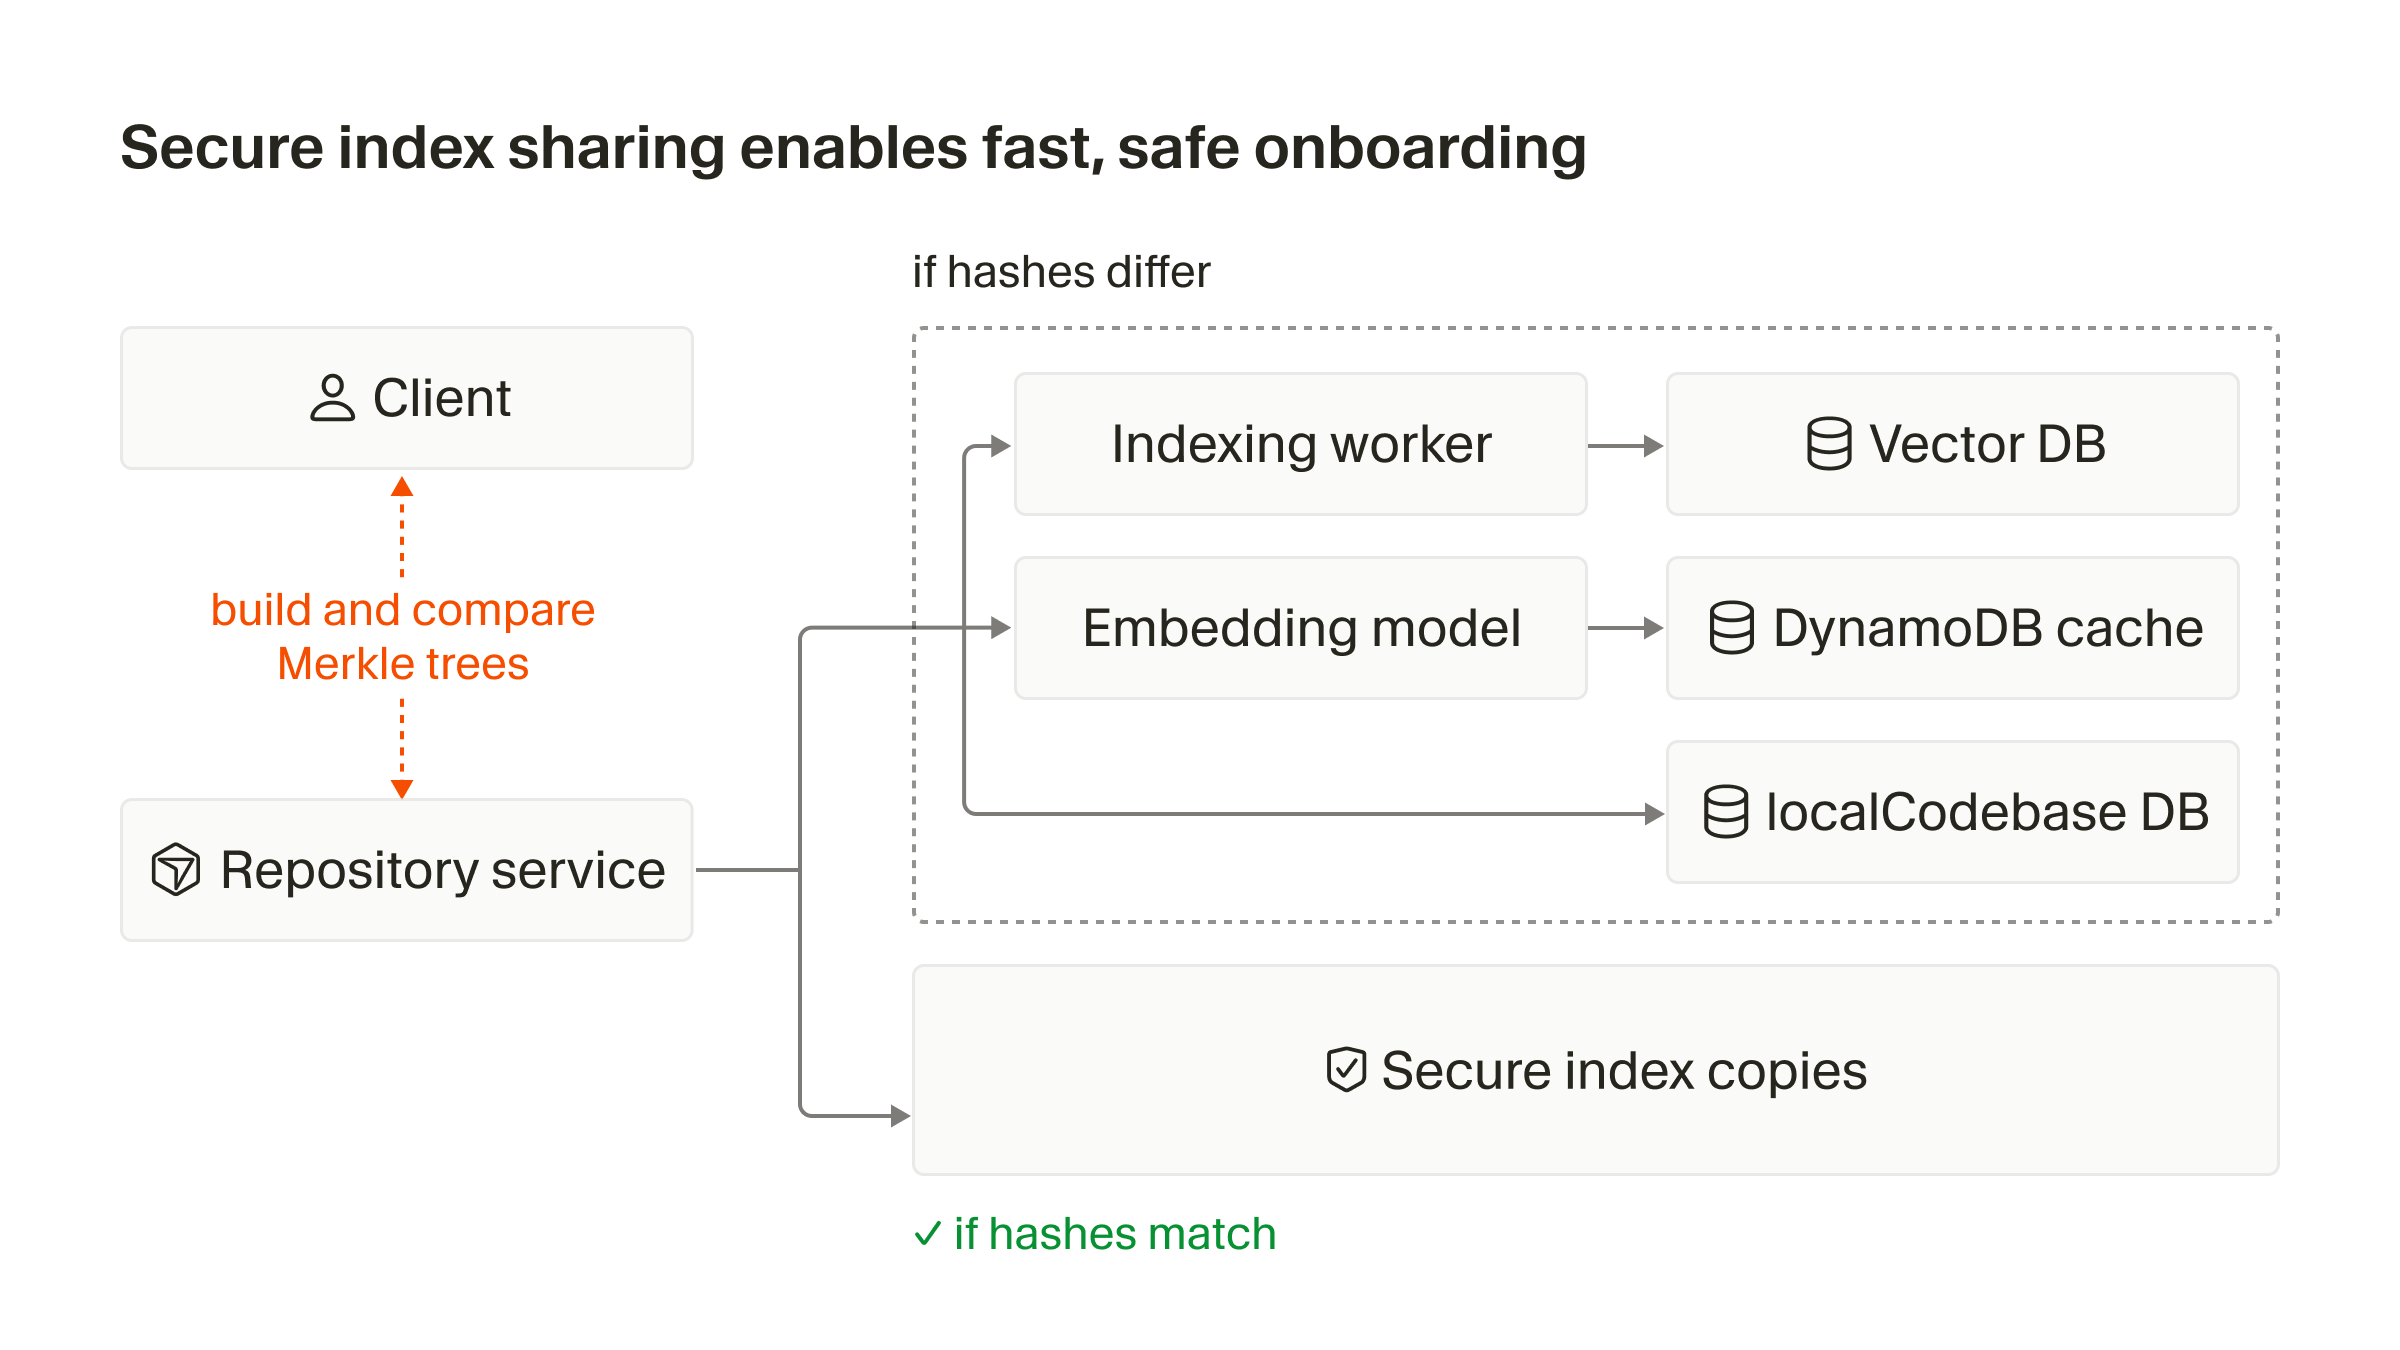
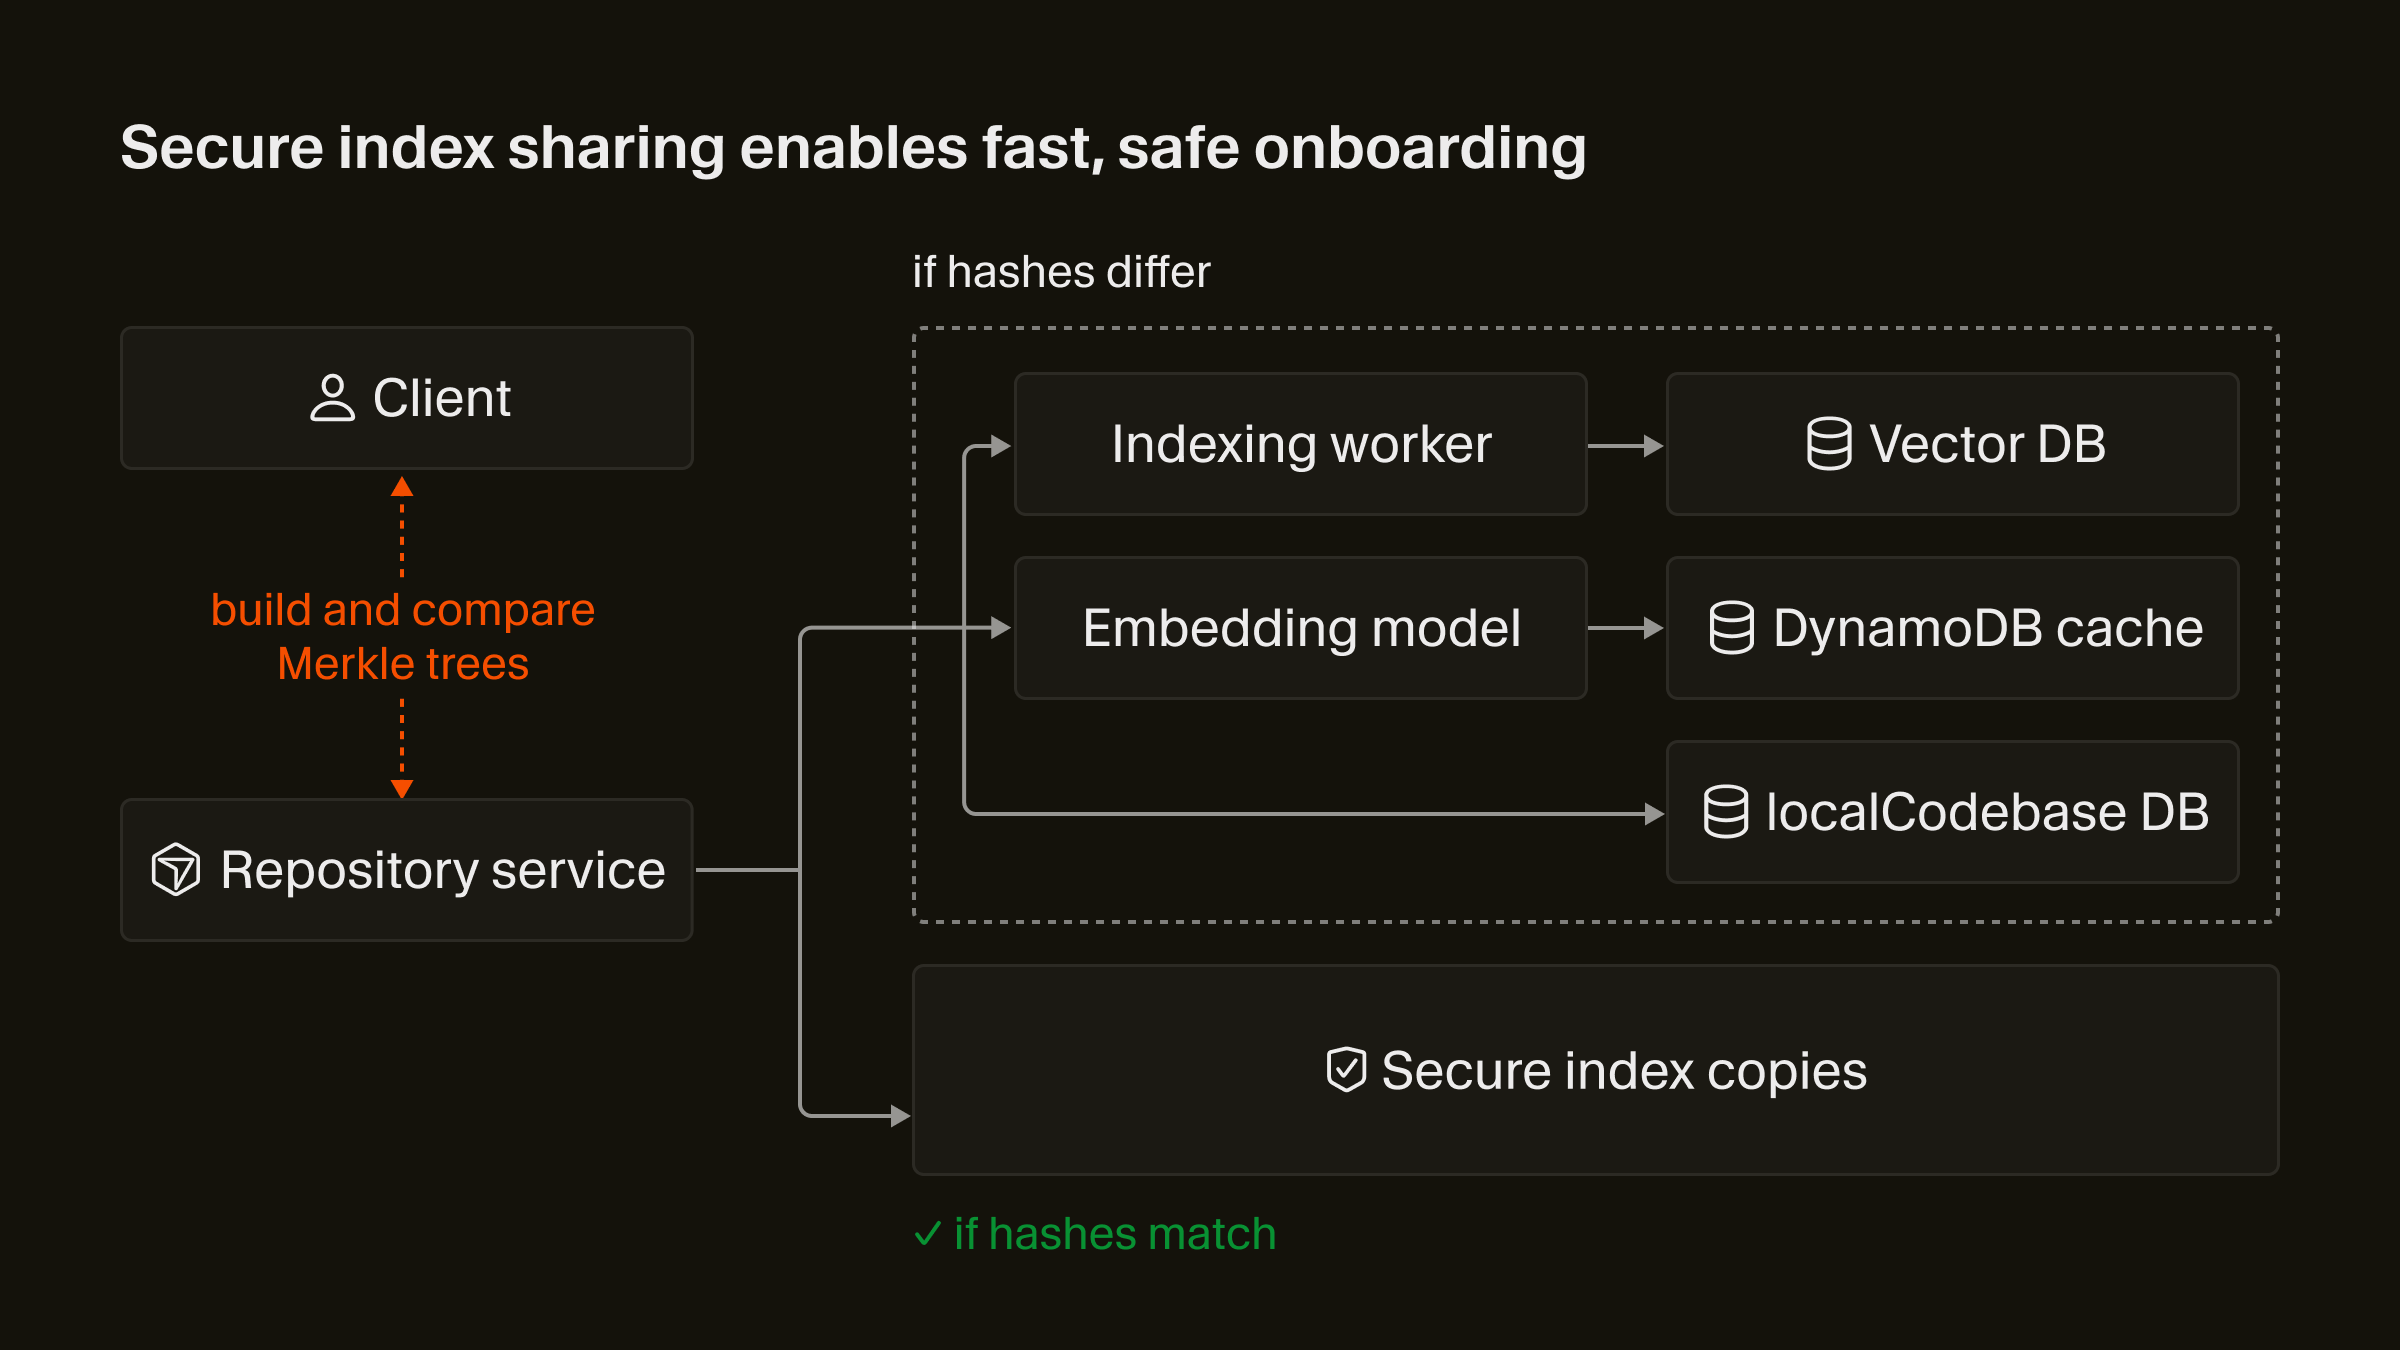
क्लाइंट simhash को सर्वर पर अपलोड करता है। फिर सर्वर इसे एक vector के रूप में उपयोग करके vector database में खोज करता है, जिसमें उसी टीम (या क्लाइंट के उसी उपयोगकर्ता) के लिए Cherri Code में मौजूद अन्य सभी मौजूदा इंडेक्स के simhash शामिल होते हैं। vector database से लौटाए गए हर परिणाम के लिए, हम जाँच करते hain कि क्या वह ऊपर दिए गए क्लाइंट similarity hash से किसी सीमा मान से अधिक मेल खाता है। अगर हाँ, तो हम उस इंडेक्स को नए कोडबेस के लिए शुरुआती इंडेक्स के रूप में उपयोग करते हैं।
यह कॉपी पृष्ठभूमि में होती है। इस बीच, क्लाइंट को कॉपी किए जा रहे मूल इंडेक्स पर नई सिमैंटिक खोज करने की अनुमति होती है, जिससे क्लाइंट के लिए पहली क्वेरी तक पहुँचने का समय बहुत कम हो जाता है।
लेकिन यह तभी काम करता है, जब दो शर्तें पूरी हों। नतीजों में उपयोगकर्ता का स्थानीय कोडबेस दिखना चाहिए, भले ही वह कॉपी किए गए इंडेक्स से अलग हो। और क्लाइंट कभी भी ऐसे कोड के परिणाम नहीं देख सकता जो उसके पास पहले से मौजूद न हो।
पहुँच का प्रमाण
यह सुनिश्चित करने के लिए कि कोडबेस की प्रतियों के बीच फ़ाइलें लीक न हों, हम Merkle tree के क्रिप्टोग्राफ़िक गुणों का पुनः उपयोग करते हैं।
tree में हर नोड उसके नीचे मौजूद सामग्री का एक क्रिप्टोग्राफ़िक हैश होता है। आप उस हैश की गणना तभी कर सकते हैं जब आपके पास वह फ़ाइल हो। जब कोई कार्यस्थान कॉपी किए गए इंडेक्स से शुरू होता है, तो क्लाइंट similarity hash के साथ अपना पूरा Merkle tree अपलोड करता है। इससे कोडबेस में हर एन्क्रिप्टेड पाथ एक हैश से जुड़ जाता है।
सर्वर इस tree को content proofs के एक सेट के रूप में संग्रहीत करता है। खोज के दौरान, सर्वर उन हैशों को क्लाइंट के tree से मिलाकर परिणामों को फ़िल्टर करता है। अगर क्लाइंट यह साबित नहीं कर पाता कि उसके पास कोई फ़ाइल है, तो वह परिणाम हटा दिया जाता है।
इससे क्लाइंट तुरंत क्वेरी कर सकता है और केवल उसी कोड के परिणाम देख सकता है जो वह कॉपी किए गए इंडेक्स के साथ साझा करता है। बैकग्राउंड सिंक बाकी अंतरों का मिलान कर देता है। जब क्लाइंट और सर्वर के Merkle tree root मेल खा जाते हैं, तो सर्वर content proofs हटा देता है और आगे की क्वेरियाँ पूरी तरह सिंक किए गए इंडेक्स पर चलती हैं।
तेज़ ऑनबोर्डिंग
टीम के साथियों के इंडेक्स का दोबारा इस्तेमाल करने से हर आकार की रिपॉज़िटरी के लिए सेटअप में लगने वाला समय कम हो जाता है। रेपो का आकार बढ़ने के साथ इसका असर भी बढ़ता जाता है:
-
औसत रेपो के लिए, पहली क्वेरी तक का समय 7.87 सेकंड से घटकर 525 मिलीसेकंड रह जाता है
-
90वें परसेंटाइल पर, यह 2.82 मिनट से घटकर 1.87 सेकंड रह जाता है
-
99वें परसेंटाइल पर, यह 4.03 घंटे से घटकर 21 सेकंड रह जाता है।
ये परिवर्तन बार-बार होने वाले काम के एक बड़े कारण को हटाते हैं और Cherri Code को बहुत बड़े कोडबेस को भी घंटों नहीं, बल्कि सेकंडों में समझने देते हैं।


