安全地為大型程式碼庫進行索引處理

語意搜尋是驅動 Agent 效能的最大因素之一。在我們最近的評估中,它平均將回應準確率提升了 12.5%,產生的程式碼變更更有可能被保留在程式碼庫中,並提高了整體請求滿意度。
為了支援語意搜尋,當你開啟專案時,Cherri Code 會為你的程式碼庫建立一個可搜尋的索引。對於小型專案,這幾乎是瞬間完成的。但對於擁有成千上萬個檔案的大型儲存庫,如果以最單純的方式進行索引處理,可能需要數小時才能完成,而且在至少 80% 的工作完成之前,語意搜尋都無法使用。
我們試圖根據一個簡單的觀察來加速索引處理:大多數團隊通常是在幾乎相同的程式碼庫副本上工作。事實上,在同一組織內,不同使用者之間的同一程式碼庫的複本平均有 92% 的相似度。
這意味著,當有人加入團隊或更換機器時,與其每次從頭重建索引,我們可以安全地重複使用隊友現有的索引。這將最大型儲存庫的首次查詢時間從數小時縮短到數秒。
建立第一個索引
Cherri Code 使用 Merkle tree 來建立它對程式碼庫的第一個視圖,這讓它能在不重新處理所有內容的情況下,精準偵測哪些檔案與目錄發生變更。Merkle tree 會為每個檔案建立一個密碼學雜湊值,並為每個資料夾建立一個基於其子節點雜湊值所計算出的雜湊。
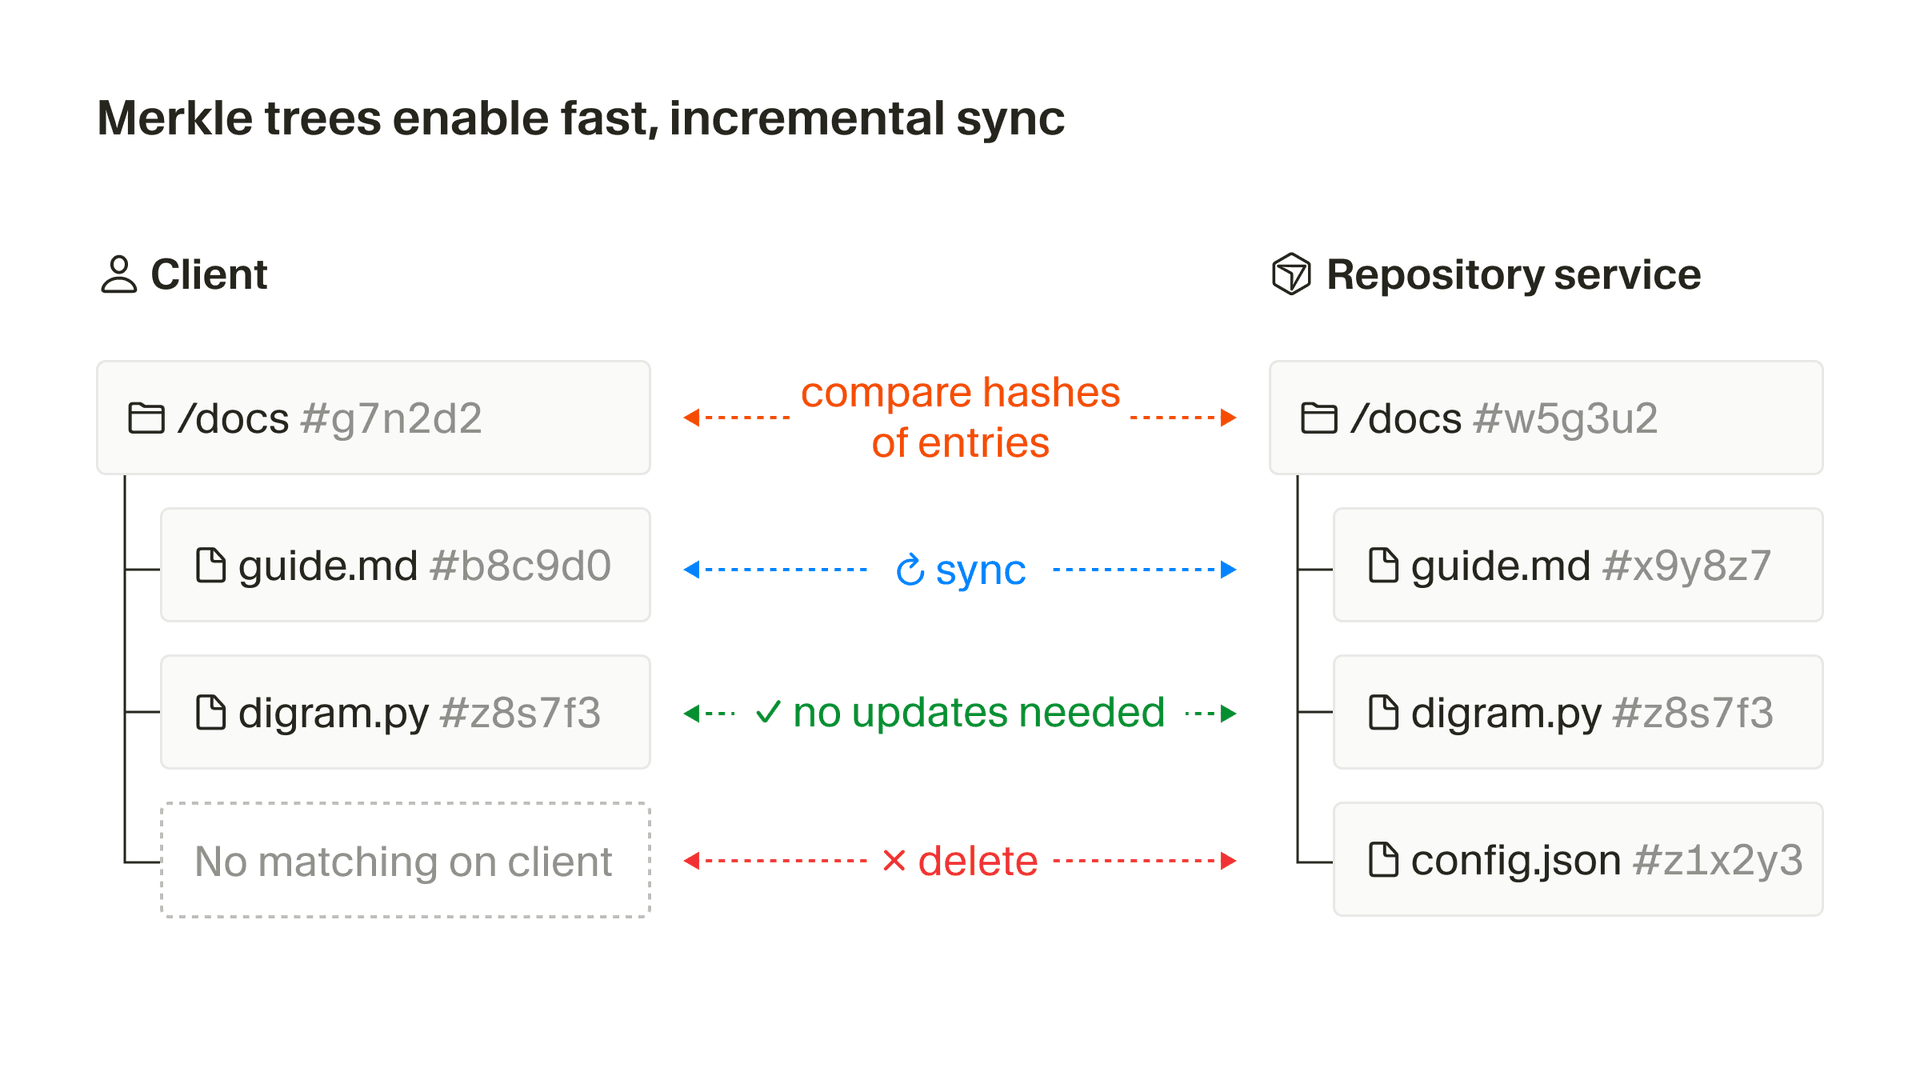
在用戶端進行的小幅編輯,只會變更被編輯檔案本身的雜湊值,以及一路到程式碼庫根目錄的各層父目錄雜湊值。Cherri Code 會將這些雜湊值與伺服器上的版本比較,以精確找出兩棵 Merkle tree 產生差異的位置。雜湊值不同的項目會被同步,相符的項目則會被略過。用戶端缺少的項目會從伺服器上刪除,而伺服器缺少的項目則會被新增。同步流程永遠不會修改用戶端的檔案。
使用 Merkle tree 的方式,大幅減少每次同步時需要傳輸的資料量。在一個包含五萬個檔案的工作區中,光是檔名和 SHA-256 雜湊值加總起來就大約有 3.2 MB。若沒有這棵樹,你每次更新都必須傳輸這些資料。有了這棵樹之後,Cherri Code 只需要走訪雜湊值不同的分支。
當檔案變更時,Cherri Code 會將它切分成語法區塊。這些區塊會被轉換成支援語意搜尋的向量嵌入 (embeddings) 。建立嵌入是成本最高的步驟,因此 Cherri Code 會在背景中以非同步方式執行。
大多數的編輯都只會讓少數區塊發生變化。Cherri Code 會依據區塊內容快取嵌入。未變更的區塊會命中快取,而 Agent 的回應在推論時就能維持高速,而不必再次付出這項成本。最終產生的索引更新快速、維護成本也很低。
尋找最適合重複使用的索引
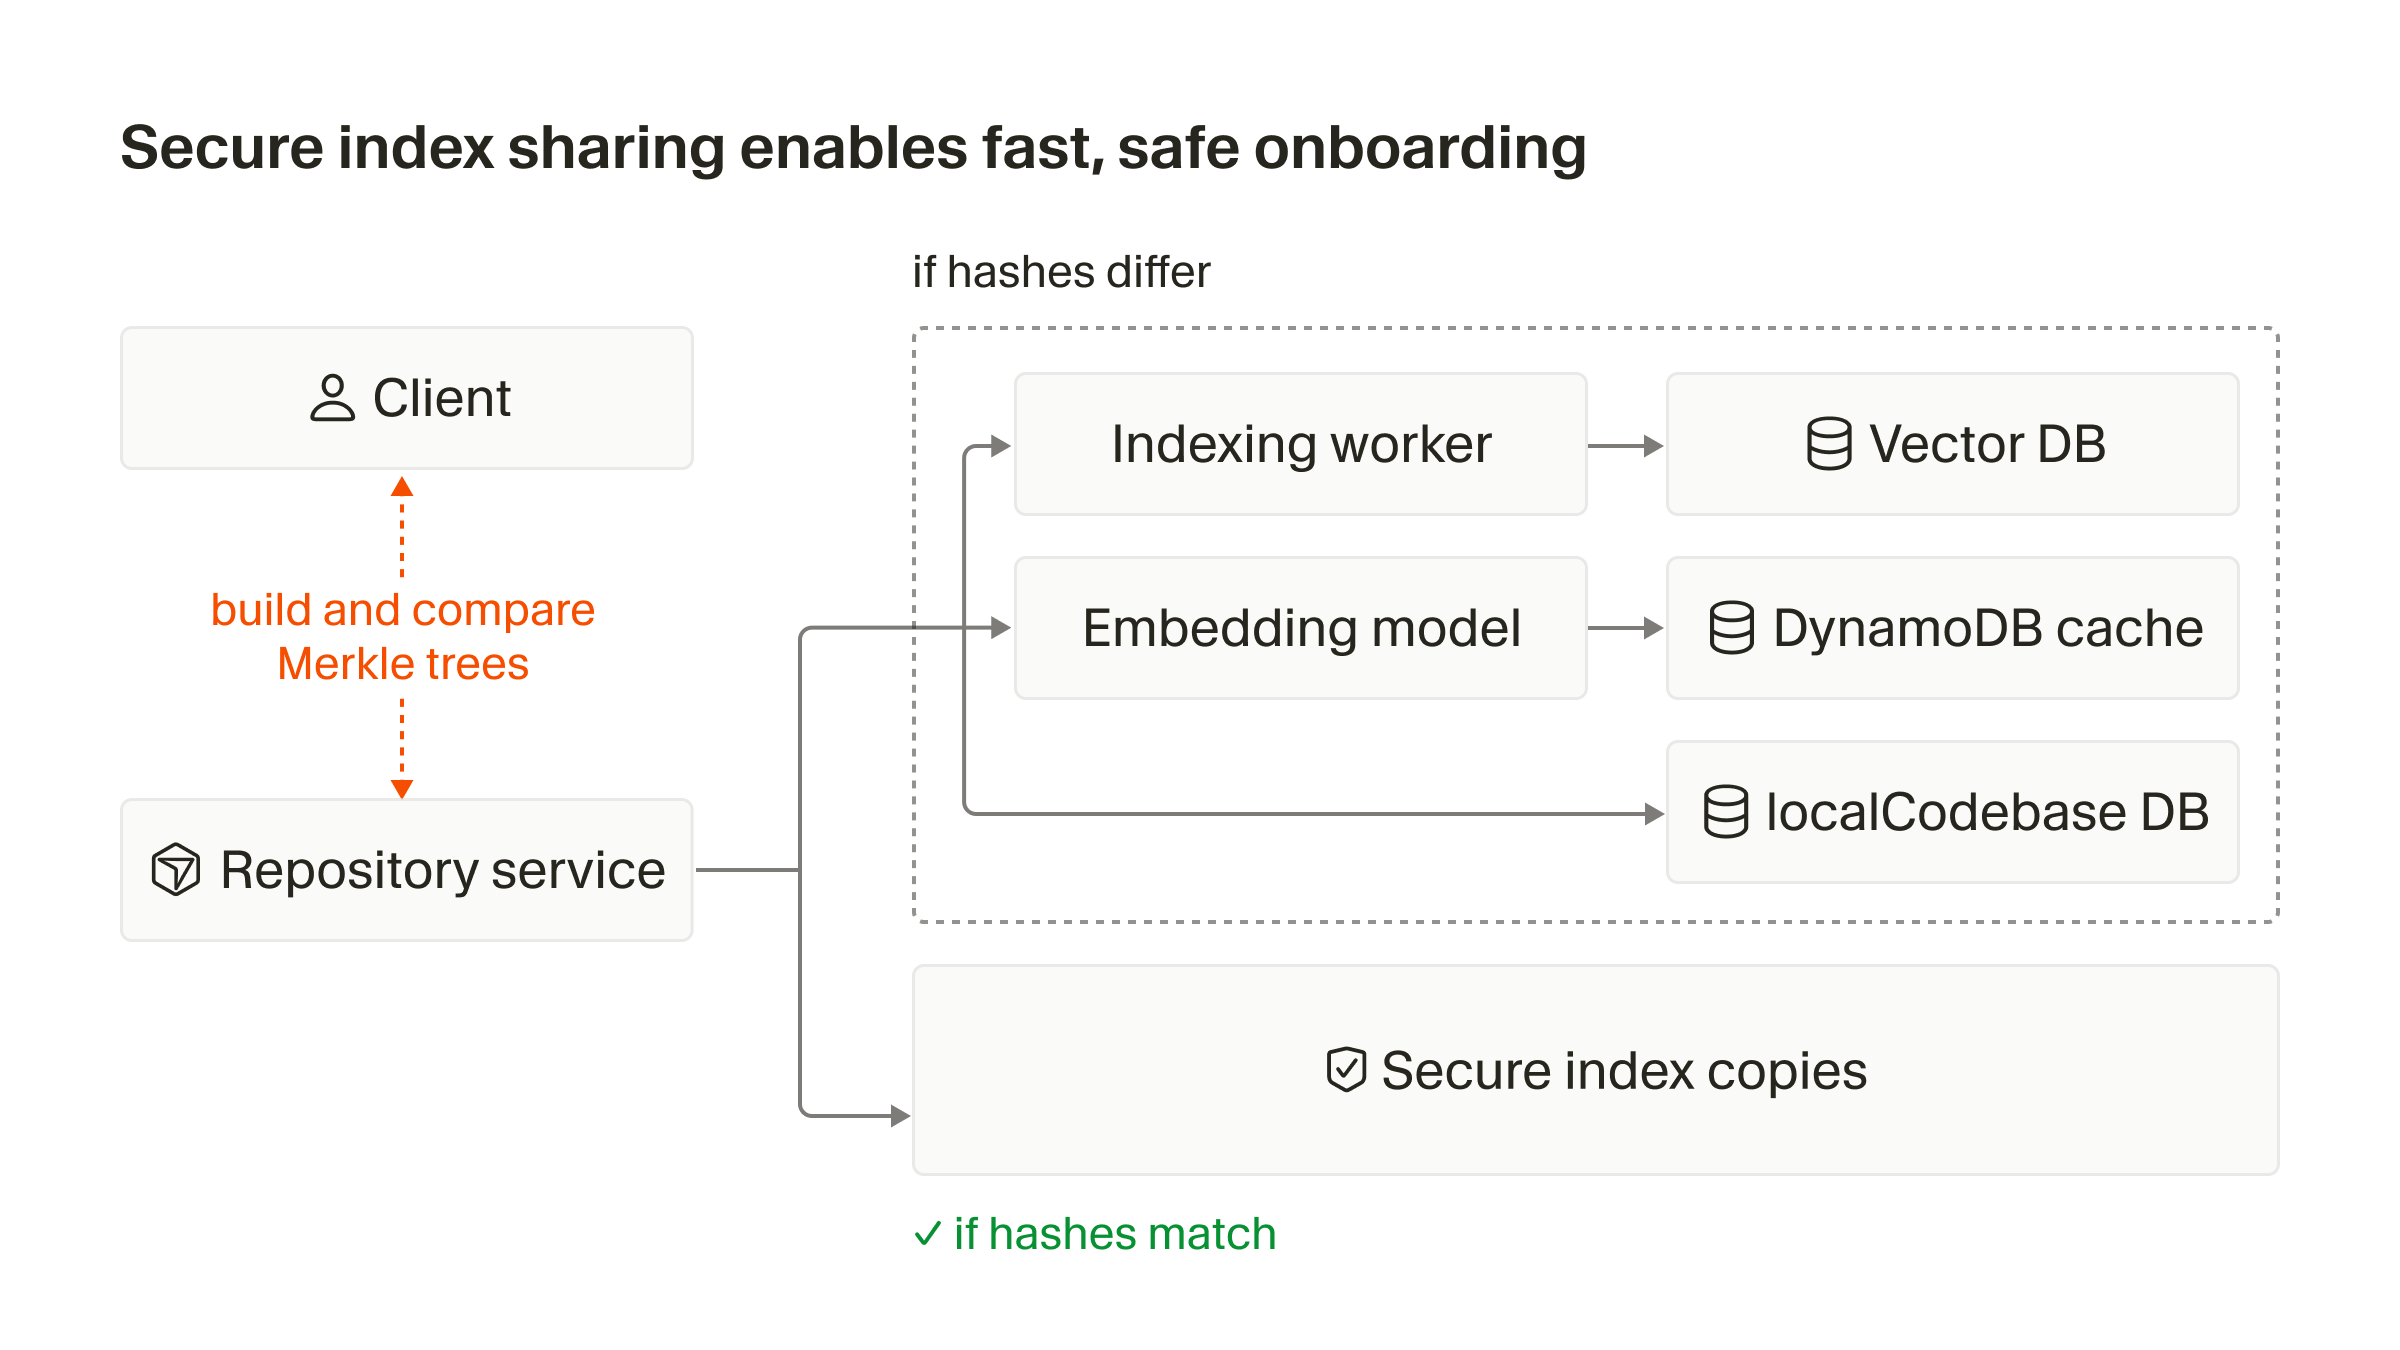
當一個程式碼庫首次被引入 Cherri Code 時,上述的索引處理管線會上傳每一個檔案。不過,組織中的新使用者不需要重新執行整個流程。
當有新使用者加入時,用戶端會為新程式碼庫計算 Merkle tree,並從該樹推導出一個稱為相似度雜湊值 (simhash) 的值。這是一個單一數值,用來作為程式碼庫中檔案內容雜湊值的摘要。
用戶端會把 simhash 上傳到伺服器。伺服器接著將它作為向量,在由同一團隊 (或同一使用者) 於 Cherri Code 中所有其他索引的目前 simhash 所組成的向量資料庫中進行搜尋。對於向量資料庫回傳的每個結果,我們會檢查它與用戶端的相似度雜湊值之間的相似度是否超過某個臨界值。如果有超過,就會使用該索引作為新程式碼庫的初始索引。
這個複製動作會在背景進行。與此同時,用戶端可以對正在被複製的原始索引發出新的語意搜尋,讓用戶端能以極短的時間完成首次查詢。
但這只在兩個限制條件都成立時才有效。搜尋結果需要能反映使用者本機的程式碼庫,即使它與被複製的索引有所不同。而且用戶端絕不能看到自己尚未擁有的程式碼內容結果。
驗證存取權
為了確保檔案不會在程式碼庫的不同副本之間外洩,我們重用 Merkle tree 的密碼學特性。
樹中的每個節點都是其下方內容的密碼雜湊。只有在你擁有該檔案時,才能計算出該雜湊值。當一個 workspace 從複製的 index 啟動時,client 會連同相似度雜湊值一起上傳其完整的 Merkle tree。這會將一個雜湊值與程式碼庫中每條加密路徑關聯起來。
server 將這棵樹儲存為一組 content proof。在搜尋過程中,server 透過將這些雜湊與 client 的樹進行比對來篩選結果。如果 client 無法證明自己擁有某個檔案,該結果就會被丟棄。
這讓 client 能立即發出查詢,並只看到與複製的 index 共享程式碼的結果。背景同步會處理其餘差異並加以對齊。一旦 client 和 server 的 Merkle tree 根節點相符,server 會刪除這些 content proof,後續的查詢將在完全同步的 index 上執行。
更快速的導入
重複使用隊友建立的索引,可以縮短各種規模儲存庫的設定時間,而且儲存庫越大,效果越顯著:
- 對於中位數的儲存庫,首次查詢時間從 7.87 秒降到 525 毫秒
- 在第 90 百分位,時間從 2.82 分鐘降到 1.87 秒
- 在第 99 百分位,時間從 4.03 小時降到 21 秒。
這些改進消除了主要的重複性工作來源,讓 Cherri Code 能在數秒內(而不是數小時)就理解即便非常龐大的程式碼庫。


